機械学習・深層学習の技術体系
人間の脳細胞(ニューロン)とシナプス結合の仕組みから着想を得た数理モデルから、非線形発火を司る活性化関数(ReLU, GELU, Sigmoid)、CNN、Vision Transformer(DETR)、強化学習(TD3/SAC)、3D ボリューム解析、波長間 Self-Attention まで。ER-FlowScan Suite を支える機械学習・深層学習の根本原理と、8 つの専門モジュールにおける技術の使い分けを体系的に解説します。
▶ 解説: 学習と推論の違い —「AIは重い」は誤解です ▶ 解説: CNN(畳み込みNN)とは ▶ 解説: MLP(多層パーセプトロン)とは
01生物学的脳(神経細胞・シナプス)と人工ニューラルネットワークの比較
ディープラーニング(深層学習)の基礎となる人工ニューラルネットワーク(ANN?Artificial Neural Network。人間の脳の神経回路網を着想源として作られた数理計算モデルの総称。)は、神経細胞(ニューロン)とシナプス結合の情報伝達メカニズムを工学的に抽象化・単純化して数理モデル化したものです。
※ 人工ニューロンは生体脳の構造から着想を得た数理モデルであり、実際の生体脳が持つ複雑な分子動態、樹状突起内での非線形統合、グリア細胞との相互作用などをそのまま再現しているわけではありません。
図 1: 生物学的神経系(上:単一ニューロン、下:神経回路網)と人工ニューラルネットワーク(上:人工ニューロン、下:多層ネットワークと順伝播・逆伝播)の構造対比。
規模・結合数・エネルギー効率の比較
| 比較項目 | 人間の脳全体(大脳皮質+小脳等) | 専門特化 AI(RF-DETR / 3D U-Net 等) | 超巨大基盤モデル(LLM / GPT-4級) |
|---|---|---|---|
| 基本素子(細胞 / 単位) | 神経細胞(ニューロン): 約 860 億個 (※大脳皮質:約160億個 / 小脳:約690億個) |
人工ニューロン・ノード: 数万 〜 数十万個 | 人工ニューロン: 数千万 〜 数億個 |
| 結合数(シナプス / 重み) | シナプス結合: 約 100 兆 〜 150 兆個(10¹⁴) | 学習パラメータ数: 約 700 万 〜 3,000 万個 | パラメータ数: 約 1 兆個規模(10¹²) |
| 信号伝達の形態 | 電気化学的スパイク(活動電位?膜電位が閾値を超えた瞬間に発生する約 +40mV のパルス状電気信号。全か無かの法則に従う。・全か無かの非同期パルス) | 連続値浮動小数点数(FP16 / FP32 テンソル) | 連続値浮動小数点数(FP8 / FP16 テンソル) |
| 学習・可塑性メカニズム | シナプス可塑性(ヘッブ則?「共に発火するニューロンは共につながる」という神経結合強化の基本則。 / LTP・LTD、局所的更新) | 誤差逆伝播法(Backpropagation / AdamW?勾配の一次モーメントと二次モーメントに適応し、正則化を分離した最適化アルゴリズム。 最適化) | 誤差逆伝播法(分散同期並列勾配降下法) |
| 消費電力・エネルギー効率 | 約 20 W(安静時代謝における概算値) | 約 70 W 〜 250 W(推論用 GPU 1台) | 数メガワット(MW)(データセンタ規模) |
| 視覚受容波長(チャネル数) | 網膜 3種錐体(S, M, L: 約 430nm, 530nm, 560nm) | 単色・RGB・3Dボリューム・16波長分光 | RGB 3 チャンネル画像パッチ |
02活性化関数(Activation Function)の数理とシナプス発火の対比
人工ニューラルネットワークにおいて、表現力の源泉となるのが「活性化関数(Activation Function)」です。 線形和(重み付き加算)に対して、なぜ非線形な活性化関数を介在させる必要があるのでしょうか。
概念理解:なぜ活性化関数(非線形性)がなければ表現力が向上しないのか?
入力ベクトルに重みを行列計算する操作は、数学的には「線形変換?原点を固定したまま、空間を直線的に回転・伸縮・平行移動させる一次変換のこと。」です。
もし活性化関数がなければ、どれだけ 100 層、1,000 層と層を重ねても、全体の合成写像は y = W₁₀₀ ··· W₂ · W₁ · x = W_total · x という「単一の線形変換」に集約されてしまいます。つまり、どれほど層を深くしても、空間に直線(平面)の境界しか引くことができません。
平らな紙のままでは直線の折り目しかつけられませんが、紙を途中で「折る・歪める(非線形変換)」ことで初めて立体的な造形が可能になるように、活性化関数を各層に挟むことで空間を歪め、複雑な非線形境界を引く表現力(万能近似定理?非線形な隠れ層を持つネットワークは任意の連続関数を理論上近似可能とする定理。ただし実際の学習における大域的最適解の探索容易性や汎化性能を直接保証するものではありません。)を獲得します。
生物物理の基礎:膜電位の「マイナス(-70mV, -55mV)」は何と比較した電圧? GND はどこ?
電子回路では基準となる電位を GND(グランド / 0 V) と定めて電位を測定します。 神経生理学において、この GND(基準 0 mV)として定義されるのは「細胞外液(細胞の外側を満たす体液環境)」 です。
細胞外液を基準(0 mV)としたとき、細胞の内側(細胞質)がどのような電位差になっているかを測った物理量が 膜電位(Membrane Potential)?細胞外液(0mV)を基準とした細胞膜の内側の電位差。安静時は約 -70mV、発火時は約 +40mV に跳ね上がる。 です。
- なぜ安静時はマイナス(約 -70 mV)なのか?: 細胞膜の「ナトリウム・カリウムポンプ(Na⁺/K⁺-ATPase)」が ATP を消費して Na⁺(ナトリウムイオン)を 3 個外に汲み出し、K⁺(カリウムイオン)を 2 個内に取り込む ため、細胞内はプラス電荷が相対的に少なくなります。さらにカリウム漏出チャネルからプラスの K⁺ が外へ漏れ出るため、細胞内は外側(0 mV)に対して常に負(静止膜電位 約 -70 mV) に分極しています。
- 閾値 -55 mV とは何か?: シナプスから神経伝達物質を受け取ると Na⁺ チャネルが開き、プラスの Na⁺ が流入して内側のマイナスが浅くなります(脱分極?刺激によってプラスイオンが流入し、細胞内のマイナス電位が 0 に近づいていく現象。)。このとき -55 mV(静止時より +15 mV ほど浅くなった状態)に達すると、電位依存性 Na⁺ チャネルが一斉に開口する臨界点に達します。
- スパイク発火(+40 mV): 臨界点を超えると Na⁺ が急速に流入し、一瞬で 細胞の内側が外側よりプラスに逆転する約 +40 mV(活動電位) まで跳ね上がります。これが神経回路におけるパルス伝達の物理的実体です。
生物学的発火(活動電位)と代表的活性化関数の数理カーブ対比
人間の神経細胞は、複数のシナプスから届いた電気信号(膜電位)が一定の閾値(約 -55 mV)を超えた瞬間に活動電位(スパイク)を発生させ、次のニューロンへ情報を送ります。AI の活性化関数は、この発火特性を着想源として発展してきました。
図 2: 生体ニューロンの活動電位発火(左:細胞外液 0mV を基準とした膜電位変化)と、深層学習の代表的活性化関数カーブ(右)。
代表的な活性化関数の進化と生物学的アナロジー
| 活性化関数・グラフ | 数式 | 生物学的シナプス・脳機能のアナロジー | 数理的特徴と工学的トレードオフ | Suite での採用モジュール |
|---|---|---|---|---|
|
ステップ関数 (Step Function) |
f(x) = 1 (x≥0) |
全か無かの法則?閾値以上の刺激には最大反応を示し、閾値未満には反応しない生物学的性質。の直接的モデル化。 閾値を超えると発火し、下回ると沈黙する。 |
最も原始的な形式。微分係数がほぼ全域で 0(不連続点では微分不能)であるため、誤差逆伝播(Backprop)による勾配降下学習が成立しない課題があり、多層学習には不適。 | 初期の歴史的モデルのみ(現代の実装では不使用) |
|
シグモイド関数 (Sigmoid) |
σ(x) = 1 / (1 + e⁻ˣ) |
神経発火の「頻度・確率」モデル。 刺激強度の増加に伴い発火確率が飽和曲線を描いて 0〜1 の区間に収束する。 |
全域で微分可能であり、出力を [0, 1] の確率値として解釈可能。二値分類やアテンションのゲート機構で多用されるが、入力が極端な領域で勾配がほぼ 0 になる勾配消失?誤差逆伝播の掛け算で微分値が極小化し、入力に近い層の重みが更新されにくくなる現象。が生じる。 | Search(EL欠陥確率)、Biohub(エッジ存在確率)、Detect(信頼度スコア) |
|
ReLU (Rectified Linear Unit) |
f(x) = max(0, x) |
脳のスパース発火?Sparse Coding。脳のエネルギー効率化のため、全ニューロンのうち同時に活動する割合が少数に制限される構造。(Sparse Coding)。 負の刺激には沈黙(0)し、正の刺激に対して比例的に興奮する。 |
正の領域で微分値が常に 1 であるため、深層でも正領域での勾配飽和が起きにくく、計算負荷が比較的小さい。CNN の標準。※ ただし負の領域に入り続けると勾配が 0 となる Dying ReLU 現象に留意。 | Solar Filament(YOLO/EdgeAttNet)、MediSeg-AI(3D U-Net) |
|
GELU (Gaussian Error Linear Unit) |
f(x) = x · Φ(x) |
確率的ゲーティング。 入力の大きさに応じて「どれだけの確率で信号を通過させるか」を標準正規分布で滑らかに確率制御。 |
負の値でも微小な勾配を保持し、全域で滑らかな微分が可能。Vision Transformer や最新 DETR、主要な言語モデル(LLM)で標準採用されている。 | OptiScan-HSI(Transformerバックボーン)、FlowCount(RF-DETR) |
|
Softmax (ソフトマックス関数) |
Softmax(zᵢ) = eᶻⁱ / Σ eᶻʲ |
側頭抑制?Lateral Inhibition。強く興奮した神経細胞が周囲の細胞を抑制し、境界線やコントラストを際立たせる神経回路の仕組み。(Lateral Inhibition)。 優勢な信号が周囲の出力を相対的に抑え、特定の知覚を際立たせる。 |
全出力ノードの合計が厳密に 1.0(100%)になる確率分布を出力。多クラス分類や Multi-Head Attention のアテンション重み算出の中核を担う。 | OptiScan-HSI(18クラス分類&波長Attention)、MediSeg-AI(多領域分類) |
03ニューラルネットワークの学習原理(順伝播・逆伝播・勾配降下法)
ニューラルネットワークの学習とは、「定義した損失関数(Loss)が最小となるように、多数の結合重みパラメータ W を数値的に最適化するプロセス」です。
2. 誤差算出(Loss) : ℒ = Loss(ŷ, y)
3. 逆伝播(Backprop): ∂ℒ/∂W = (∂ℒ/∂ŷ) · (∂ŷ/∂z) · (∂z/∂W) [微分の連鎖律 (Chain Rule)]
4. 重み更新(AdamW) : W ← W - η · m̂ / (√v̂ + ε) - η · λ · W [重み減衰付き適応的勾配]
入力データが各層の重みと活性化関数を通過して予測値を算出する「順伝播」に対し、正解とのズレ(損失)を後ろの層から前の層へと微分の連鎖律(Chain Rule)を用いて逆流させるのが「誤差逆伝播法(Backpropagation)」です。これにより、各パラメータの勾配を数値的に効率よく算出し、オプティマイザ(AdamW?勾配の一次モーメント(移動平均)と二次モーメント(適応学習率)を考慮し、L2 正則化を勾配更新から分離することで過学習を抑制し安定収束を図るオプティマイザ。 等)によってパラメータを更新します。
学習過程デモ:強化学習による倒立振子制御(CartPole × PPO)
教師あり学習が「正解データとの誤差」を逆流させて重みを更新するのに対し、強化学習(Reinforcement Learning)は環境から得られる報酬(Reward)を最大化する方策(Policy)を試行錯誤で獲得します。以下は倒立振子(CartPole)を PPO(Proximal Policy Optimization)で学習させた際の、学習初期・中盤・終盤のエージェントの振る舞いです。学習初期は数秒で棒が倒れてエピソードが繰り返しリセットされますが、学習が進むにつれて倒れるまでの時間(生存ステップ数)が伸び、終盤では安定して立ち続けます。
PPO(Proximal Policy Optimization:近接方策最適化)は OpenAI が2017年に提案した方策勾配法で、現在も最も広く使われる強化学習アルゴリズムの一つです。構成は Actor-Critic 型で、行動を出力する方策ネットワーク(Actor?状態 s を入力として、各行動を取る確率分布(連続制御では平均・分散)を出力する方策ネットワーク。本デモでは ±10 N の推力を決定する。)と、その状態がどれだけ有望かを推定する価値ネットワーク(Critic?状態 s から得られる将来報酬の期待値 V(s) を推定するネットワーク。Advantage 計算の基準値として使われる。)を並行して学習させます。
目的関数 : L(θ) = E[ min( r_t(θ)·Â_t, clip(r_t(θ), 1−ε, 1+ε)·Â_t ) ] (ε ≈ 0.2)
Advantage : Â_t = 実際の報酬 − Critic の推定値(その行動が平均よりどれだけ良かったか)
PPO の核心は「方策を一度に大きく変えすぎない」ことです。方策比率 r_t が 1±ε の範囲を超えた分はクリップして勾配をゼロにするため、学習が進むほど良かった方向への更新は続きつつ、急激な方策変化による性能崩壊(性能が振動して収束しない問題)を防ぎます。先行手法の TRPO が複雑な制約付き最適化を必要としたのに対し、PPO は同じ効果を簡単なクリップ演算で実現するのが特徴です。本デモでは 2,048 ステップぶんの経験をまとめて収集し、そのバッチに対して複数エポックの勾配更新を行うことで、得た経験を効率的に学習に使い回しています。
※ この動画は学習途中のチェックポイントを実際に読み込んで再生した記録であり、イメージ映像ではありません。120,000 ステップは dt=0.02 s のシミュレーション時間に換算すると約 40 分間の試行錯誤に相当し、PC 上では約 5 分で学習されます(実時間 40 分ぶんの経験を約 8 倍速で消化)。CartPole × PPO の典型的な収束は 5 万〜20 万ステップとされるため、この学習量は標準的〜むしろ速い部類です。強化学習は正解データ無しに「報酬の勾配」を統計的に推定するため、教師あり学習より本質的に多くのサンプル数を要します。
発展デモ:カート上二重倒立振子(Double Inverted Pendulum)
振り子の棒に関節をもう一つ追加した二重倒立振子は、リンク同士の結合振動とカオス的な挙動を持つ代表格の難問です。単一振り子が約12万ステップで収束したのに対し、こちらは約40万ステップを要し、学習曲線の立ち上がりがはるかに遅いことが分かります。制御対象が複雑になるほど「試行錯誤の回数」が爆発的に増えるのが強化学習の実務上の課題です。
さらなる発展:真下からの振り上げ(Swing-up)
二重振り子が最初から真下に垂れ下がった状態から、カートの往復運動による反動だけで両リンクを振り上げ、倒立姿勢を目指すスイングアップ課題です。安定化とは異なり「まず十分なエネルギーをポンピングで注入する → 倒立域で急制動してキャッチする」という2つの異なる技能を1つの方策で学ぶ必要があり、強化学習の難関として知られています。報酬は「どこまで持ち上げられたか(到達高さ)」と「倒立域を維持できたか(保持)」を分けた段階報酬に加え、「小さい振り幅・低速での到達」を評価する整形項を与え、倒立近傍やキャッチ流域からの初期化も混ぜた混合分布でゼロから学習させています。
※ 検証の経緯(アルゴリズム比較・固定シード各100エピソードで評価):最初は PPO で学習しましたが、ポンピング→倒立直前到達までしか学べず、到達時に第2リンクの角速度が残り持続保持は未達成でした。平衡点の線形制御(LQR)を教師にした行動クローン保持方策との複合構成でも間欠的な成功に留まりました(流域到達率 7%、95%信頼区間 3–14%)。オフポリシー系の SAC は当初 100 万ステップでは流域到達率 5%(2–11%)と不安定でしたが、replay buffer の蓄積を仮説に 200 万ステップで再学習したところ、TD3 と同水準(流域到達率 100%、長尺保持中央値 約48 秒)に到達し、経験再生の量が制動精度の決め手であることを裏付けました。TD3 は replay buffer による「稀な成功到達」の再利用で精密制動を獲得し、単一方策で振り上げ→制動→保持を達成しました(流域到達率 100%、95%信頼区間 96–100%)。さらに 340 万ステップまで継続学習した方策は、100 秒窓の限界評価で保持中央値 約98.5 秒・流域到達 中央値 約0.5 秒を記録しています。対照的に SAC 側は到達 約2.1 秒と穏やかですが、一度キャッチすれば 100 秒窓の全 50 エピソードで終了まで流域を離れない、より堅固な保持を示しました。学習シードを変えた再現検証(seed=2 で TD3 240万・SAC 200万ステップを新規学習し、同一シード50エピソード・100秒窓で評価)でも、両方策とも流域到達率 100%・保持中央値 約98〜99秒を再現し、「TD3 は到達が速い(中央値 約0.8秒 vs SAC 約2.5秒)」という特性差が保たれ、seed=2 では両方策とも全50エピソードが一度も流域を離れず終了まで保持しました。残る課題は実機への転移です。
04画像解析における主要アーキテクチャの進化と軽量・高効率バックボーン
コンピュータビジョン(CV)の歴史は、「局所特徴を捉える受容野の制御」「勾配消失を防ぐ残差構造」「計算量とメモリ帯域の削減」、そして「大域的関係性を捉えるアテンション機構」の探求によって進化してきました。
ER-FlowScan Suite では、単一の汎用モデルに頼るのではなく、解析タスクの物理的次元、タクトタイム、エッジPCの計算資源に合わせて最適なニューラルネットワーク構造を選択しています。
| アーキテクチャ分類 | 得意とする情報構造 | 数理的特徴 | Suite での採用モジュール |
|---|---|---|---|
| 軽量・高効率 CNN (MobileNetV2 / EfficientNet) |
エッジ推論・低遅延特徴抽出・リソース制約環境 | Depthwise Separable Conv、Inverted Residuals、Compound Scaling、Squeeze-and-Excitation | Detect(エッジ推論骨格)、FlowCount(軽量バックボーン)、MediSeg-AI(U-Netエンコーダ) |
| 2D CNN / U-Net | 局所的テクスチャ・微細輪郭 | 畳み込みカーネルによる並進不変性・受容野?Receptive Field。1つの出力特徴が入力画像のどれくらいの広さを見ているかを表す範囲。制御・スキップ接続 | Solar Filament(微細亀裂抽出)、Search(EL欠陥特徴抽出) |
| Vision Transformer (DETR / RF-DETR 系) |
大局的関係性・複数物体の同時同定 | Multi-Head Self-Attention?画像内の全領域同士の相互関係を複数の視点(ヘッド)から同時に内積計算し、長距離の依存関係を捉える機構。 による End-to-End 物体検出(NMS不要) | Detect(Few-Shot)、FlowCount(高速計数)、OptiScan-HSI |
| 3D CNN (Temporal/Spatial) | 3次元空間ボリューム・時系列変化 | Z軸や時間軸を含む 3D 畳み込みフィルター?XY平面だけでなく、スライス深さ(Z)や時間(T)方向にも同時にカーネルを滑らせて立体特徴を抽出する手法。 | MediSeg-AI(3D脳MRI)、Biohub(発生胚4D時系列) |
| Spectral Attention | 16〜224波長バンド間の物理共起相関 | 波長トークン間内積による分光反射率シグネチャ抽出 | OptiScan-HSI(真贋・材質識別) |
4.1. MobileNetV2:反転残差(Inverted Residuals)と線形ボトルネック
エッジ・組込み向け標準従来の CNN(VGG や ResNet)は高い認識精度を持つ反面、膨大な積和演算量(FLOPs)とメモリ帯域(MAC)を消費し、工場のエッジ PC やラインカメラ内プロセッサでのリアルタイム実行には制約がありました。この課題を抜本的に解決したのが MobileNetV2(Sandler et al., 2018) です。
空間方向の畳み込み(\(K \times K\) Depthwise)とチャネル方向の畳み込み(\(1 \times 1\) Pointwise)を完全分離。通常の畳み込みに対し計算量を約 \(\frac{1}{K^2} + \frac{1}{C_{out}} \approx \frac{1}{8} \sim \frac{1}{9}\)(\(K=3\) 時)に削減。
従来の ResNet(太い ➔ \(1\times 1\)で圧縮 ➔ \(3\times 3\) ➔ \(1\times 1\)で復元)とは逆に、「細い低次元入力 ➔ \(1\times 1\) で 6 倍拡張(Expansion) ➔ \(3\times 3\) Depthwise ➔ \(1\times 1\) で圧縮」とし、メモリを圧迫しない低次元同士をスキップ接続。
低次元空間で ReLU を適用すると、負値が 0 に切り捨てられて情報多様体が不可逆的に破壊される(Manifold Collapse)。そのため、最終の \(1\times 1\) 圧縮層の直後は非線形関数を通さず線形(Linear)のまま出力。
4.2. EfficientNet:複合スケーリング(Compound Scaling)と MBConv + SE ゲート
精度と効率の黄金比従来のモデル拡張手法は、「層数を増やす(Depth: レイヤー数)」「チャネルを増やす(Width: 幅)」「入力解像度を上げる(Resolution)」のいずれか単一の次元のみを拡大するのが通例でした。しかし、解像度を上げれば受容野を広げるために深さが必要になり、細部のテクスチャを捉えるために多くのチャネル(幅)が必要になります。
EfficientNet(Tan & Le, 2019) は、これら 3 つの次元を固定の比率で同時に拡大する「複合スケーリング則(Compound Scaling Rule)」を確立し、従来の 1/5 以下のパラメータ数で最高水準(State-of-the-Art)の精度を達成しました。
深さ(Depth): \(d = \alpha^\phi\), 幅(Width): \(w = \beta^\phi\), 解像度(Resolution): \(r = \gamma^\phi\)
制約条件: \(\alpha \cdot \beta^2 \cdot \gamma^2 \approx 2\) (\(\alpha \ge 1, \beta \ge 1, \gamma \ge 1\))
※ \(\phi\)(ユーザー指定のスケーリング係数: B0〜B7)を 1 増やすごとに、モデルの総計算量(FLOPs)が約 \(2^\phi\) 倍にバランスよく拡大されます。
4.3. 代表的画像認識バックボーンの性能・計算効率・産業適用マトリクス
| モデル | ImageNet Top-1 精度 | パラメータ数 | 演算量 (FLOPs) | エッジ推論適性 | ER-FlowScan Suite での活用方針 |
|---|---|---|---|---|---|
| ResNet-50 (基準) | 76.1 % | 25.6 M | 4.1 G | 標準(GPU推奨) | 標準CNNベースライン比較検証用 |
| MobileNetV2 | 72.0 % | 3.4 M (1/7) | 0.3 G (1/13) | 極めて高い(CPU/エッジ完結) | FlowCount / Detect の高速ライン通過検知エッジモデル |
| EfficientNet-B0 | 77.1 % (+1.0%) | 5.3 M (1/5) | 0.39 G (1/10) | 高い(エッジGPU / 高速CPU) | MediSeg-AI / Search の高効率エンコーダ骨格 |
| EfficientNet-B4 | 82.9 % (+6.8%) | 19.3 M | 4.2 G | 中程度(GPU推奨) | 高解像度欠陥検査・精密セグメンテーション(Solar Filament / EL) |
| RF-DETR (Transformer) | 85.0+ % (mAP) | 28.0 M | 4.5 G | GPU / TensorRT 最適化 | OptiScan-HSI / FlowCount の多波長・エンドツーエンド物体検出 |
05自己教師あり学習(Self-Supervised Learning / AutoEncoder / MSM)
大量の人手による正解ラベル(アノテーション)を前提とする従来の「教師あり学習」に対し、データ自身の一部をマスク・隠蔽して復元させることで、ラベル不要で本質的な物理特徴を自己獲得する手法が「自己教師あり学習(Self-Supervised Learning: SSL)?データ自体から擬似的な問題(マスクされた領域の予測や再構成)を作り出し、人手のアノテーションなしに特徴表現を学習する枠組み。」です。
近年の深層学習(LLMや最新Vision Transformer)の急速な進化は、この自己教師あり学習による「① 未ラベル大量データでの事前学習(Pre-training) ➔ ② 少数ラベルでの下流タスク適応(Fine-tuning)」という2段階パラダイムによって牽引されています。
未知の環境・欠陥に適応しにくい
一部をマスク・隠蔽して自律復元
本質的特徴表現を自律獲得
目的の判定タスクへ効率的に適応
ラベル作成工数・アノテーションコストを大幅抑制
図 3: 従来の教師あり学習(上:高価な人手ラベル依存・過学習)と自己教師あり学習(下:未ラベル大量データでの事前学習 ➔ 少数ラベルでのファインチューニング)のパラダイム対比。
ER-FlowScan Suite では、この自己教師あり学習の仕組みを 「Search(EL検査)の正常品オートエンコーダによる未知異常検知」 や、「OptiScan-HSI の 224 バンド事前学習(Masked Spectral Modeling)」 に直接実装しています。
- 正常品のみで学習可能: 良品データのみで潜在空間を構築するため、異常画像の収集コストを大幅に削減。
- 未知の異常パターンを高感度に検知: デコーダは正常パターンしか復元できないため、未知の傷や異物が入ると再構成誤差 \(|X - \hat{X}|\) が顕著に上昇。
- Suite 適用: Search(ELセル微細クラック自動スクリーニング)
- 化学吸収帯の物理連続性: 反射スペクトルはランダムではなく化学構造(C-H, O-H結合等)に従う。
- 光と物質の相互作用を事前獲得: 隠された波長を復元させることで、AI が物理的特徴表現を自律学習。
- Suite 適用: OptiScan-HSI(16〜224バンド分光物体検出)
図 4: 自己教師あり学習の2大メカニズム(左:正常品から潜在空間を圧縮獲得し未知異常を残差検出する AutoEncoder、右:波長をランダムマスクして物質の分光物理法則を自己学習する Masked Spectral Modeling)。
自己教師あり学習の主要手法と Suite での使い分け
| 手法カテゴリ | 事前学習のタスク設計(Pretext Task) | 獲得される内部表現の性質 | Suite での採用モジュール |
|---|---|---|---|
| AutoEncoder (AE / VAE) | 正常画像の圧縮・再構成(入力と出力を一致させる) | 正常データの低次元多様体(Manifold)。 未知の傷や異物が入ると再構成誤差(Residual)が急増し、ラベルなしで異常箇所をピクセル単位で特定。 |
Search(ELセル未知欠陥スクリーニング)、Solar Filament(背景ノイズ除去) |
| Masked Spectral Modeling (MSM) |
連続波長スペクトルの 70〜80% をマスクし、欠損した波長反射率を周囲から予測復元 | 物質の分光反射シグネチャと化学吸収帯の物理連続性。 数万件の未ラベル分光キューブから「分光の物理特徴」を事前獲得し、ファインチューニングの収束を効率化。 |
OptiScan-HSI(16/224バンド分光バックボーン) |
| Masked Autoencoder (MAE / Vision MAE) |
画像パッチの 75% をランダムに消去し、残りのパッチから元の画像全体をピクセル復元 | 画像内の大局的トポロジー・空間文脈構造。 少数のラベル付きデータでも過学習を抑え、高精度な物体検出・個体分割が可能。 |
Detect(One-Shot DETR事前学習)、FlowCount(人物ReID特徴) |
| Contrastive Learning (対照学習 / SimCLR 系) |
同一画像の異なるデータ拡張ペアを近づけ、異なる画像の表現を遠ざける | 照明変動・幾何変形に不変な不変特徴量(Invariance)。 照明ムラやアングル変化に対して堅牢な特徴埋め込みベクトルを獲得。 |
FlowCount(カメラ間人物再同定 ReID)、Search(類似欠陥検索) |
06汎化性能・「次元の呪い(Hughes現象)」と厳密な検証設計
ディープラーニングにおける重要な課題は、学習データだけに過剰適合して未知の現場画像に対する精度が低下する「過学習(Overfitting)?学習データに含まれる個別のノイズや背景特徴まで過剰に適合してしまい、未知のテストデータに対する予測精度が低下する現象。」です。 特に、200波長以上を扱うハイパースペクトル解析や多断面ボリューム検査では、「次元の呪い(Hughes現象)」への対策が不可欠となります。
「次元の呪い(Hughes現象)」と波長間の超高相関(Collinearity)
ハイパースペクトル(HSI)データでは、隣り合う波長同士(例: 1000nm と 1005nm)の相関係数が r ≥ 0.99 と極めて高くなります。
サンプル数が限られた状態で 224 チャンネルをそのまま全結合や多層 CNN に投入すると、特徴空間の体積が指数関数的に増大してデータ密度が希薄化(超疎空間化)します。
その結果、パラメータ数が過剰に増大し、「学習データ(Train)への適合が進む一方で、未知の現場データ(Test)に対する認識精度が低下する」という汎化性能の低下(Hughes現象?サンプル数が一定のとき、特徴量の次元数(バンド数)を増やしすぎると、ある最適点を超えてから未知データに対する分類精度が逆に低下する現象。)が発生します。
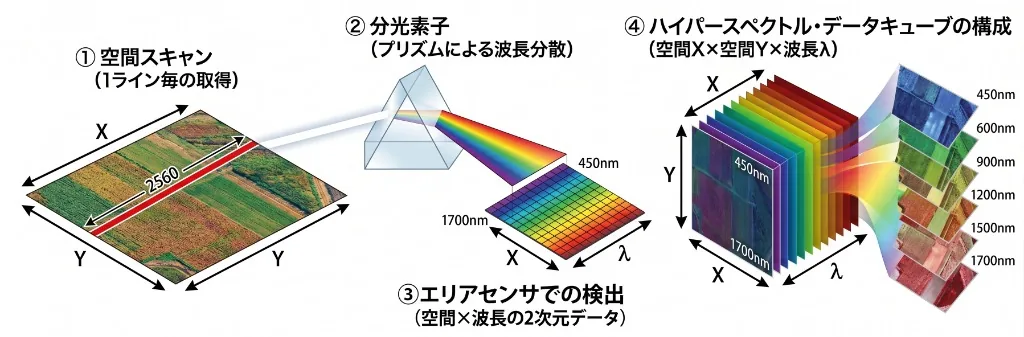
図: ①ライン空間スキャン ➔ ②プリズム分光素子による波長分散 ➔ ③2次元エリアセンサ受光 ➔ ④空間2軸+波長1軸の「3次元データキューブ(Data Cube)」生成。
- 多重共線性(コリニアリティ): 隣接波長(1000nm と 1005nm)の相関が
r ≥ 0.99と極めて高い。 - パラメータの過剰な肥大化: 重み数が膨張し、ノイズまで学習。
- 光散乱・距離ムラ(ベースライン変動)がノイズとして混入。
- 超疎空間化: サンプル数が有限なため、超高次元空間を十分にカバーできない。
x_snv(λ) = ( x(λ) − μ_x ) / σ_x・SG :
x''(λ) = d²/dλ² [ PolyFit(x(λ)) ]
図 5: ハイパースペクトル解析における「次元の呪い(Hughes現象)」の過学習メカニズム(左)と、SNV・Savitzky-Golay微分・1D-Spectral Conv による分光学的前処理・特徴圧縮パイプライン(右)。
厳密な交差検証と物理整合性のあるデータ設計
- 漏洩のないデータ分割(Stratified & Group K-Fold?クラス比率を保ち(Stratified)、かつ同一患者・同一セッションのデータが学習と検証にまたがらないよう隔離(Group)して分割する厳密な交差検証。): 同一患者・同一撮影セッション・同一ロットの画像が学習と評価に混ざらないよう厳密に隔離。
- 単一モデル(Single-Model)制約とアンサンブルの使い分け: 運用環境(エッジPC / オンプレミス)の制約に応じて、軽量単一モデルでの収束安定化とアンサンブル(Bagging / Blending?複数の独立したモデルの予測を平均化・統合することで、単一モデルのブレを抑えて予測を安定させる手法。)を設計。
- 物理整合性のあるデータ拡張: 単純な幾何反転に加え、分光シグネチャを破壊しない波長ゲインジッターなど、物理法則に即したロバスト性を獲得。
07ER-FlowScan Suite 8モジュールへの技術適用
各モジュールがどのような深層学習技術を活用して現場課題を解決しているか、技術解説ページから詳細をご確認いただけます。
16バンド分光物体検出
16波長可視光テンソル × Transformer 波長間 Self-Attention による真贋・材質識別。
Solar Filament微細フィラメント個体分割
YOLO-seg 候補検出 × U-Net 輪郭精密化による細線トポロジー抽出。
Biohub3D+時間 細胞系譜追跡
3D U-Net × 時間方向 Transformer × 整数計画法(ILP)による分裂グラフ再構成。
MediSeg-AI3D 医用セグメンテーション
多断面 2.5D/3D U-Net と Case-level 3D Dice による病変領域の定量化。
DetectOne-Shot ライン計数
数枚の現場画像指定から即時推論する One-Shot DETR 検出パイプライン。
Search太陽電池 EL 一括検査
CNN による特徴埋め込みベクトル探索と人手判定(HITL)監査の接続。
FlowCount人流動線・群衆計測
RF-DETR 人物検出 × 外観 ReID 埋め込みによる高精度トラッキング。
Architecture3層ハイブリッド体系
深層学習 × 古典数理アルゴリズム × 人手確認(HITL)の統合設計。