00公開ベンチマークにおける検証スコア
444 チームが参加する国際コンペティションにおいて、自社開発の EdgeAttNet(EG-MHSA 境界精密化)モデル は暫定 Public LB 0.39(444チーム中 13〜16位相当) を記録しています。 本コンペの主催者は公式ディスカッション(2026年8月20日)において、「PQ スコアが 0.35 を超えるモデルは学術的・実用的に大きな価値がある」と明言しており、当社の検証モデルはこの基準を上回る水準に到達しています。 さらに2026年9月のフォーラム分析により、上位クラスタ(0.55〜0.56)の多数がテストセットと公開データセットの重複(リーク)に由来するスコアであることが判明しました。当社モデルはリークを一切用いない実測値として、この課題で実質最上位の水準に位置しています。
主催者公式見解における有用性基準(Competition Organizers, 2026年8月20日):
“Looking at some submissions, it is clear to us that some participants are spending their time and energy on hacking the system rather tackling the actual problem. We encourage honest participants to continue their work without comparing their scores with others. Any PQ score of greater than 0.35 is of great value to us.”
(主催者アナウンス要約:課題本来に向き合う参加者に対し、他者スコアとの過度な比較にとらわれず研究を継続することを推奨するとともに、「PQ スコアが 0.35 を超えるモデルであれば、科学的・実用的に非常に大きな価値がある」と公式見解が示されています。)
リーダーボード上位クラスタの実態(2026年9月15日 確認):
Kaggle公式フォーラムでの参加者分析(複数者が独立に再現・確認)により、テストセット180枚中139枚(77.2%)が公開データセット MAGFiLO 1.0 の正解付き画像とバイト単位で一致していることが判明しました。0.55〜0.56 に38チーム規模で並ぶ上位クラスタは、この重複を利用したスコアと整合的です。当社はMAGFiLOの正解アノテーションを学習に一度も使用していない(競技規約でも禁止)ため、Public LB 0.39 はリークを用いない誠実なモデルの実測値です。主催者は「評価はリーダーボードのスコアに基づかない(定量70%+定性30%の合議制)」と明言しています。
図: 国際コンペにおける主要モデルのスコア位置づけ(Public LB, 2026年9月時点)。上位クラスタ(0.55〜0.56、38チーム規模)はテストセットと公開MAGFiLOの77.2%重複に由来するスコアと判明しており、リークを用いない提出の実態は 0.37〜0.40 のクラスタ帯です。当社モデル(0.39)は主催者有用性基準(PQ > 0.35)を上回り、この誠実なティアの最上位に位置しています。
アプローチの要点 — 4つの工学設計
微細線状セグメンテーション課題における代表的なアプローチとしては、① 全体の画素を二値分類した後に連結成分で分離するセマンティック手法、② 物体検出器の生出力をそのまま用いる単段のインスタンスセグメンテーション(YOLO-seg 等)、の 2 系統が広く用いられます。
しかし、いずれの手法も IoU?Intersection over Union。予測した範囲と正解の範囲がどれだけ重なっているかを 0〜1 で表す指標。1 に近いほど一致度が高い。 > 0.5 の急峻な閾値特性(不連続ペナルティ) や 複数アノテータ由来の加算分母 という本課題特有の数理構造に十分適応した構成とは言えません。
当社では評価指標の数式を厳密に分解した上で、以下の 4 つの工学的アプローチを統合して検証しています。
Instance-First 2段パイプライン
全体画素を直接分類するセマンティック手法に対し、YOLO11m-seg で個体境界を検出した上で精密化する instance-first 構成を採用。単一モデル構成により推論処理時間を抑制。
IoU > 0.5 の特性に配慮した閾値設計
Panoptic Quality?個体ごとの輪郭一致度と、検出漏れ・誤検出の両方をまとめて1つの数値にする評価指標。本コンペの公式採点方式(略称 PQ)。 の損益分岐式 p·u > 0.5·PQ を導出し、FP 減点を抑えつつ near-miss?正解にかなり近いが、採点の合格ライン(IoU>0.5)にわずかに届かなかった予測のこと。 を拾い上げる信頼度閾値(conf?confidence threshold(信頼度しきい値)。モデルが「これは個体だ」と判定する自信度の下限。低くすると検出は増えるが誤検出も増える。 0.26)を検証・設定。
EdgeAttNet(EG-MHSA)による境界精密化
エッジ誘導型自己注意(EG-MHSA)を U-Net ボトルネックに導入し、内側削り込み shrink = refined ∧ proposal との組み合わせで Public LB 0.39(+0.02) を達成。パラメータ一致アブレーションにより「改善の主因は注意機構の容量増加であり、エッジ誘導固有の寄与は確認されなかった」ことも検証・記録済み。
Group Split 3-Fold & ブートストラップ検証
観測画像単位の厳密な Group Split?同一の観測画像に由来するパッチデータが学習用と検証用の両方に混在することを防ぐため、「観測画像」単位でグループ分割する方法。同一被写体の背景特徴への過剰適合(データ漏洩)を防ぎ、客観的な汎化性能を測定します。 に加え、2,000回のペア化観測クラスタ・ブートストラップにより、改善効果(95%信頼区間)を統計的に検証する評価体制を確立。
01歴史的背景 & 専門家アノテーションの限界(一致度ベースライン)
太陽フィラメントは境界が拡散的であり、専門家による目視トレースにおいても個人差が生じやすい対象です。 MAGFiLO データセットの解析により、専門家間における個体レベルの一致率は約 53.9%(複数アノテータ観測における PQ 0.3398)となっています。 (2026-08-30訂正:算出コードに参照アノテータ自身との自己比較が混入する不具合があり、旧数値0.7587/0.6051は水増しされていました。単一アノテータ画像を除外し自己比較を取り除いて再計算した正確な値です。)
図: MAGFiLO データセットにおける専門家アノテータ同士の不一致度解析(自社集計・複数アノテータ観測296枚、2026-08-30訂正版)。専門家間でも個体一致率は 53.9%(PQ 0.3398)にとどまる一方、自社AIモデル(Public LB 0.39 / OOF 0.4454)は主催者基準(PQ > 0.35)を上回る水準を確認しています。
このスコア水準と主催者有用性基準(PQ > 0.35)の解釈: 「AIが人間より優れている」という意味ではありません。フィラメントの境界そのものが拡散的で個人差が大きいタスクにおいて、専門家同士の一致限界(複数観測 PQ 0.3398)を踏まえたとき、コンペ主催者が公式アナウンス(2026年8月20日)で示した「PQ > 0.35 は学術・実用上大きな価値がある」という基準は、この専門家間のばらつきの限界を実用上の有効な閾値として設定したものと整合的です。自社モデル(Public LB 0.39 / 全Fold OOF 0.4454)は、複数アノテータの学習データを通じて安定したコンセンサス的境界を捉えることで、この有用性基準を安定して上回る水準に到達しています。
図: 全Fold OOF(社内確定値 0.4454)と Public Leaderboard(大会暫定値 0.39)の評価条件の違い。OOF は全707観測を網羅した統計的確定値であるのに対し、Public LB は未知テストの一部(約20〜30%)を対象とした小規模サブセットでの採点であるため、評価母集団や注釈者分布が異なり単純比較はできません。
一見すると社内の OOF スコア(0.4454)の方が高く見えますが、これは「モデルが社内データでのみ高スコア」という意味ではなく、評価しているデータ母集団の規模とアノテータ分布が異なることによる統計的な差です。社内では全707観測という大規模母集団で厳密な汎化性能を測定・確認した上で、大会本番の未知データに対しては計算コストを抑えた Fold 2 単体モデルで 0.39 を達成しています。
本タスクの正解アノテーション基準および複数専門家による注釈構造は、オープンアクセス論文 A dataset of manually annotated filaments from H-alpha observations(Ahmadzadeh et al., Nature Scientific Data 11, 1031, 2024. DOI: 10.1038/s41597-024-03876-y)に基づいています。
※ 本サイトに掲載している黄色い検出輪郭は、自社開発 AI モデルが推論により独自に算出した成果物であり、データセットに含まれる手作業アノテーションの再配布ではありません。
NASA SDO(Solar Dynamics Observatory)観測データについて
太陽フィラメントは、太陽の縁(リム)から宇宙空間に突き出るとプロミネンス(紅炎)として明るく輝き、太陽面を背景にすると光を吸収して黒い筋状のダークフィラメントとして観測されます。
NASA の SDO 衛星(AIA 機器、波長 304 Ångstrom)による極紫外線観測データは、約 50,000 K のイオン化ヘリウム(He II)を捉えることで、この巨大な磁気フィラメントのダイナミクスを極めて高い解像度で捉えています。
※ 本研究・検証で参照している太陽観測画像および関連データは、NASA Media Usage Guidelines に準拠し、公開科学データとして活用しています。
Image/Data Credit: Courtesy of NASA/SDO and the AIA, EVE, and HMI science teams.
02対象構造の実態 — 前景率わずか 0.23% の微細対象 & 実際の検出例
太陽フィラメント検出の主な難しさは、「広大な太陽画像の中に、ごくわずか(約0.23%)しか存在しない極小・極細の暗部を1本ずつ切り分ける」点にあります。
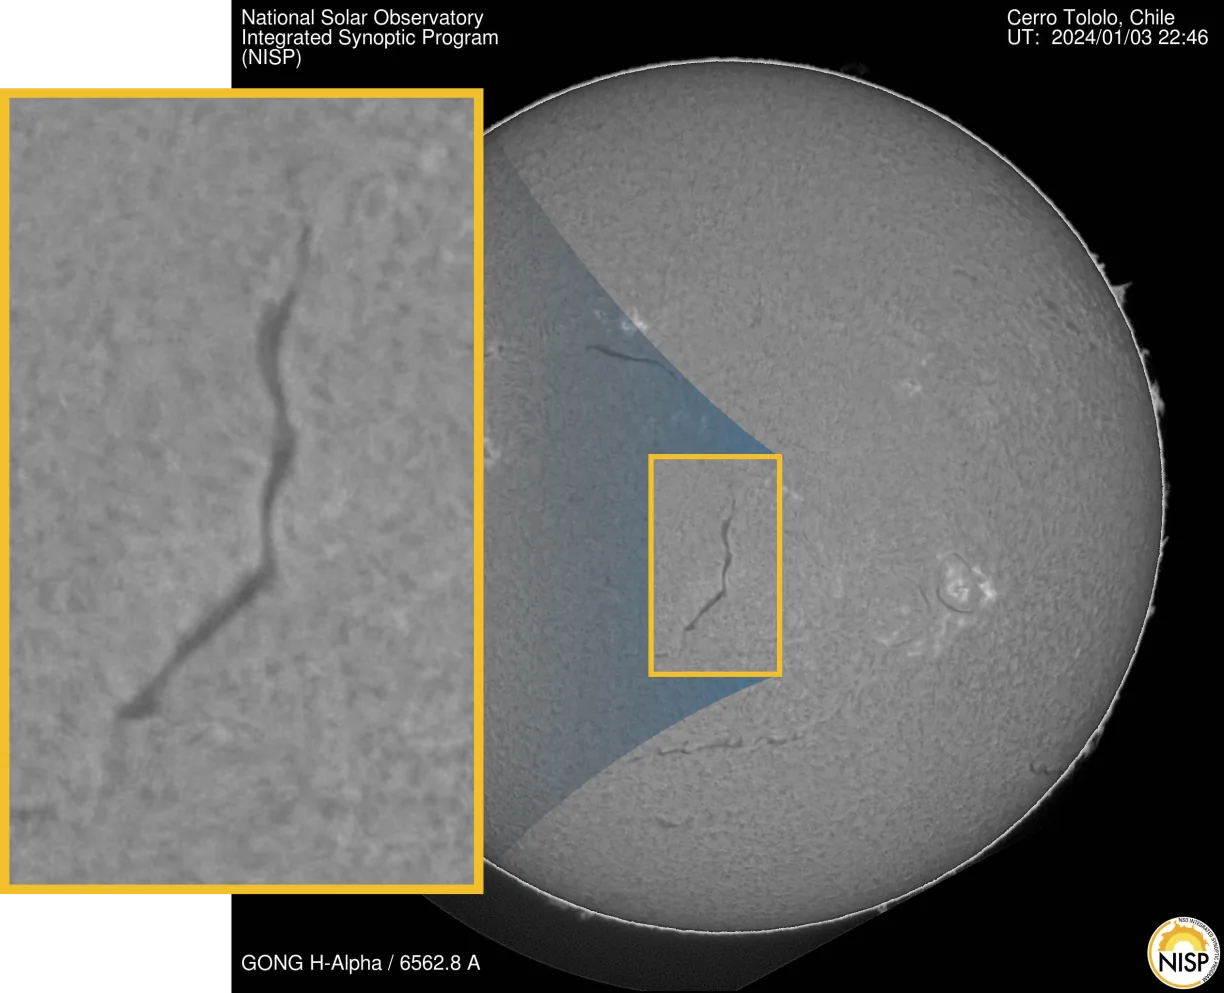
太陽全面(2048px)と極微細フィラメント
全体画像(右)に対して、フィラメント領域(黄枠ズーム)は針の穴のように小さく、太さはわずか数画素幅。背景ノイズや太陽の減光(limb darkening)に埋もれる極微細構造を漏れなく捉える必要があります。
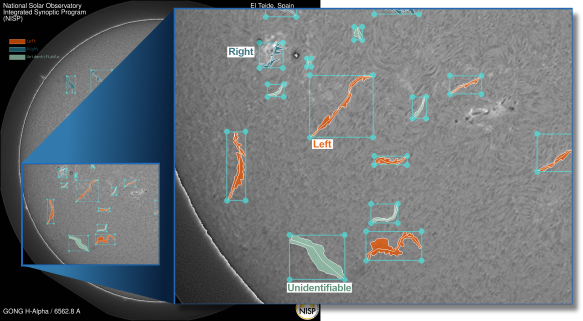
複雑な分岐(Spine & Barb)と個体境界
フィラメントは主軸(spine)から微細な足(barb)が伸びており、近接する暗部同士が繋がっているように見えます。どこまでを1本の個体と定義するか、専門家の間でも見解が分かれる複雑な境界を判定します。
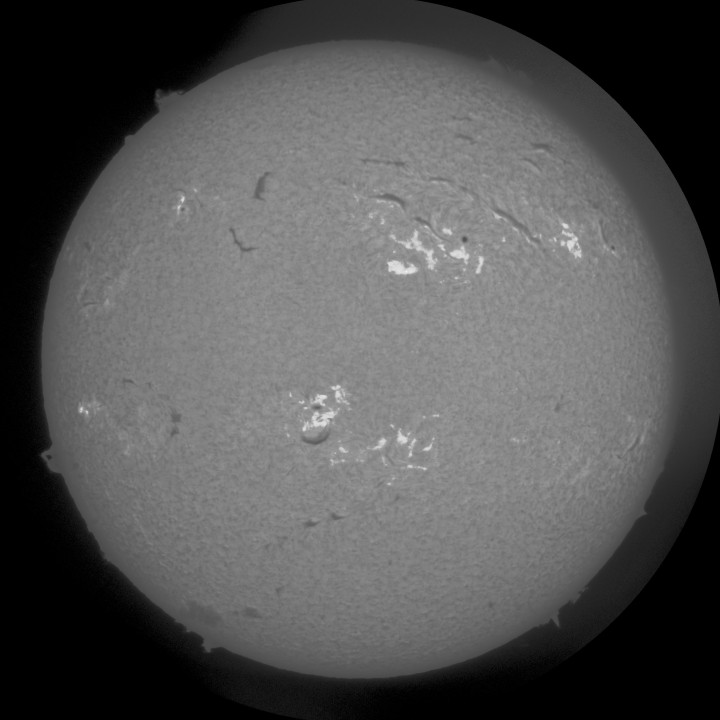
AIモデルは太陽のどこを検出しているか — 生データと検出輪郭の対比
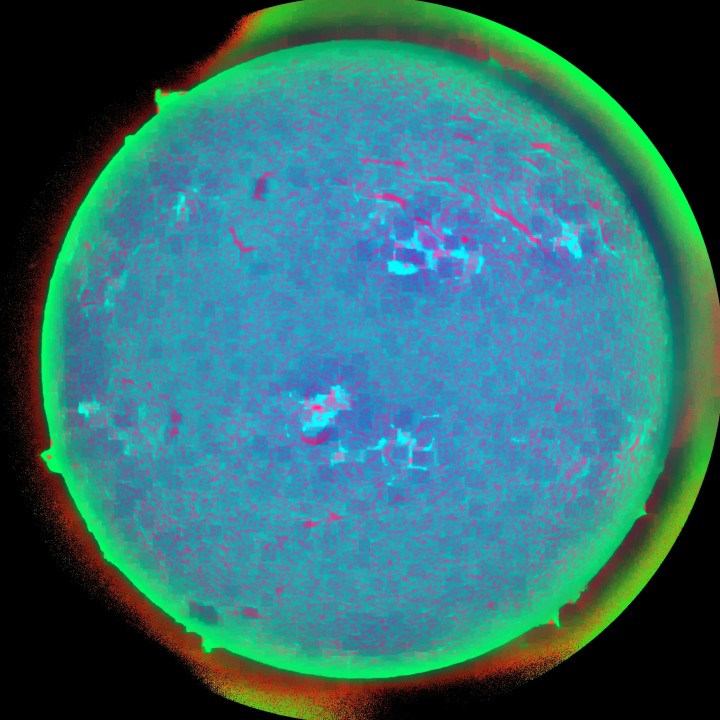
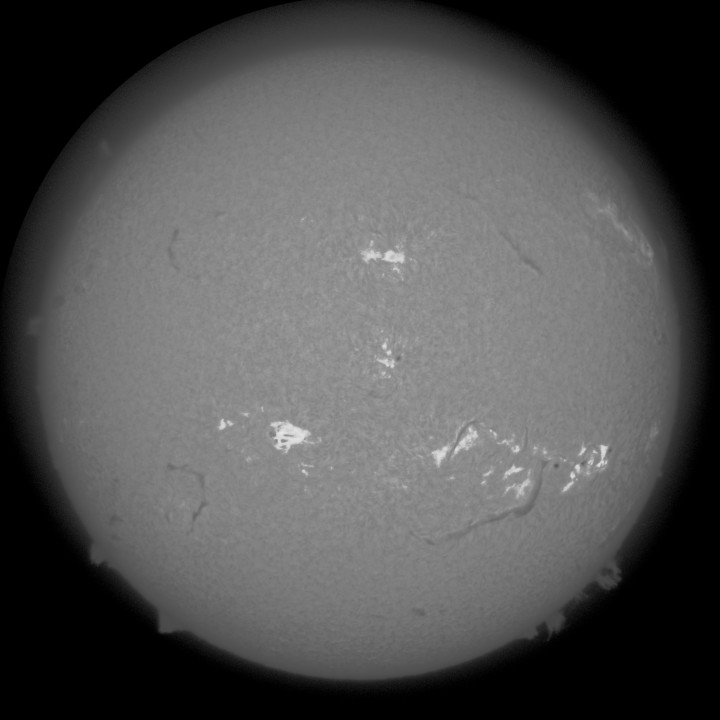
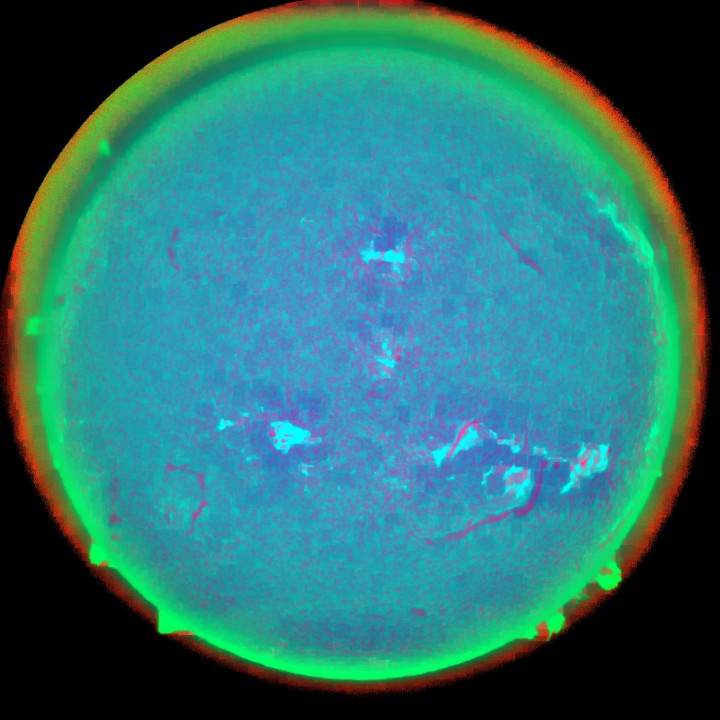
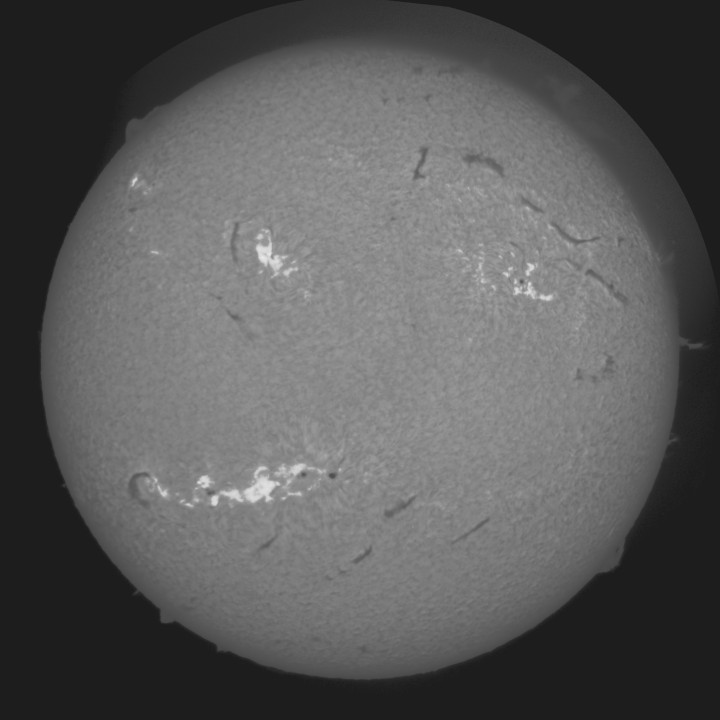
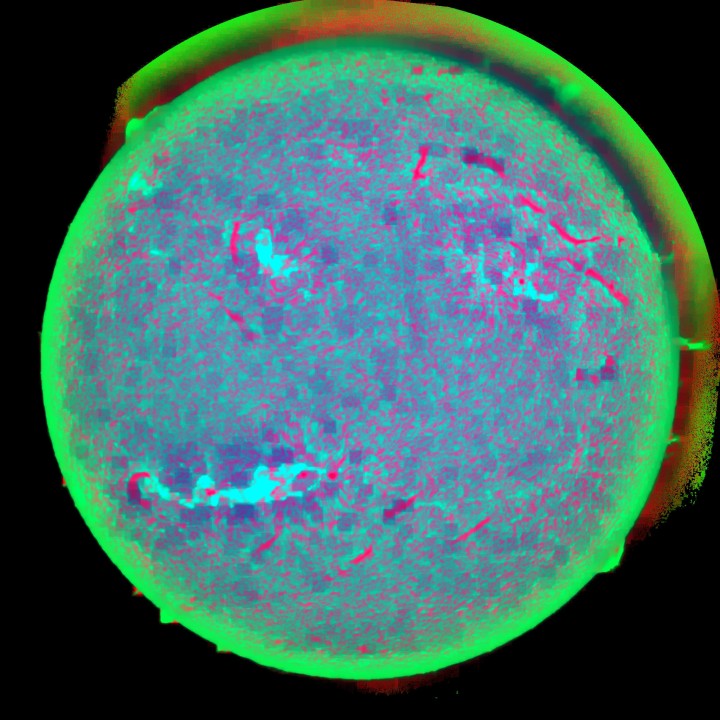
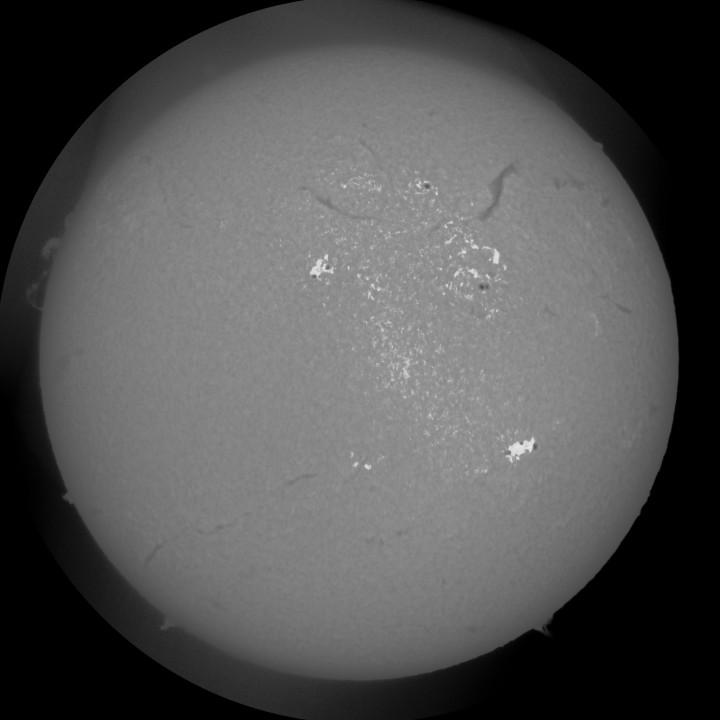
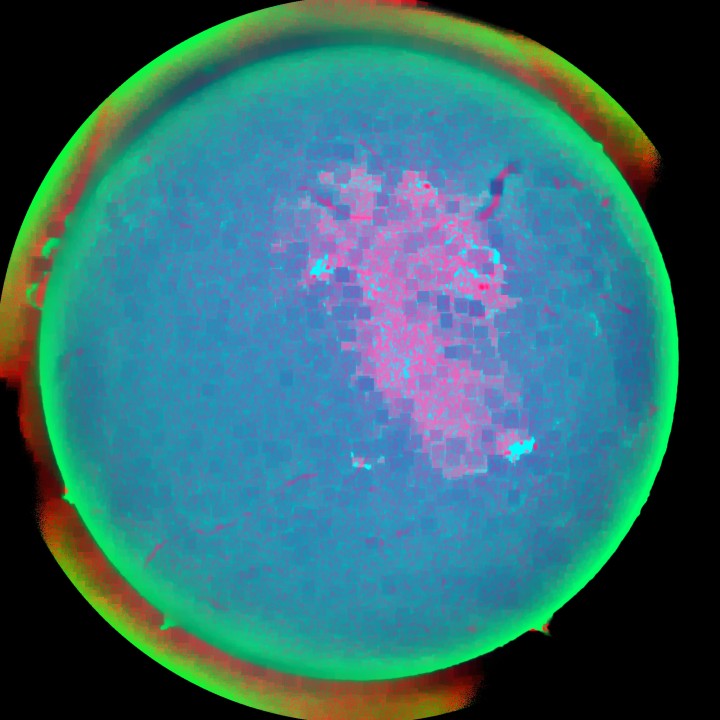
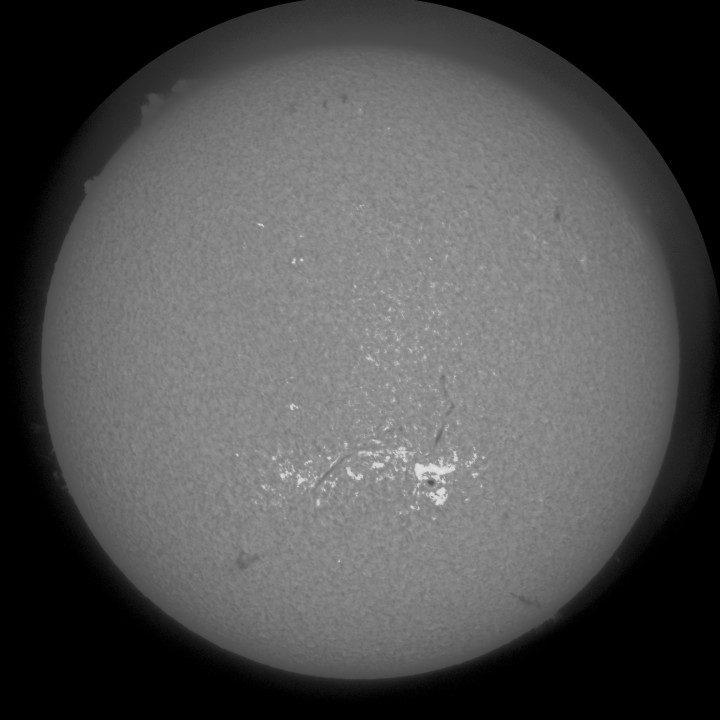
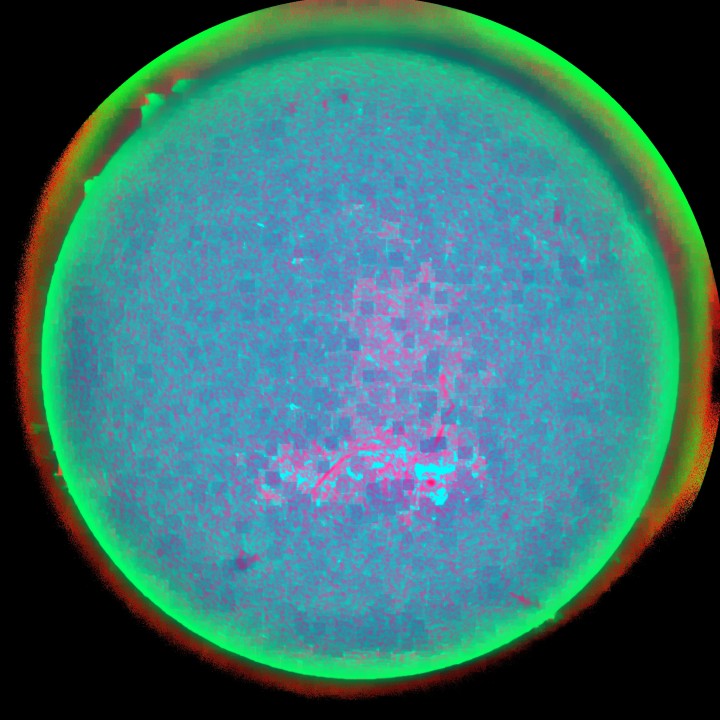
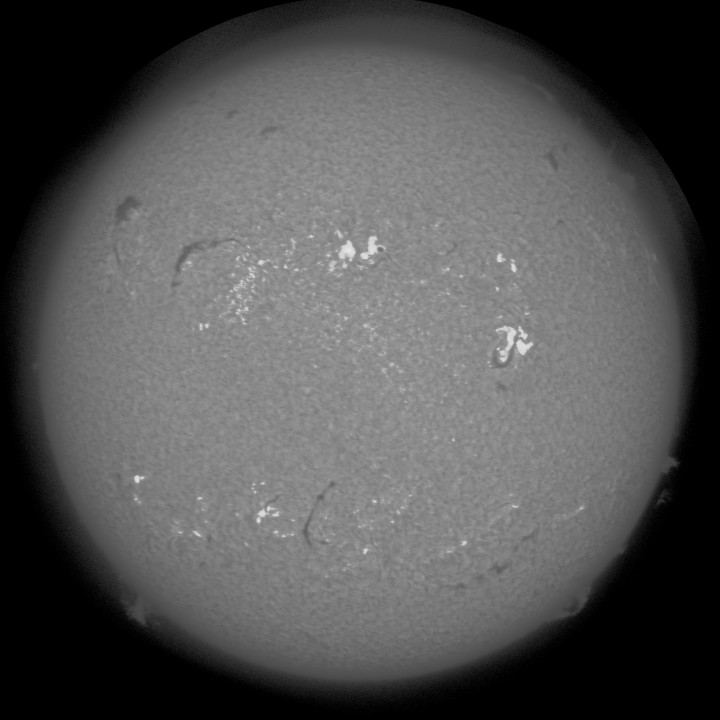
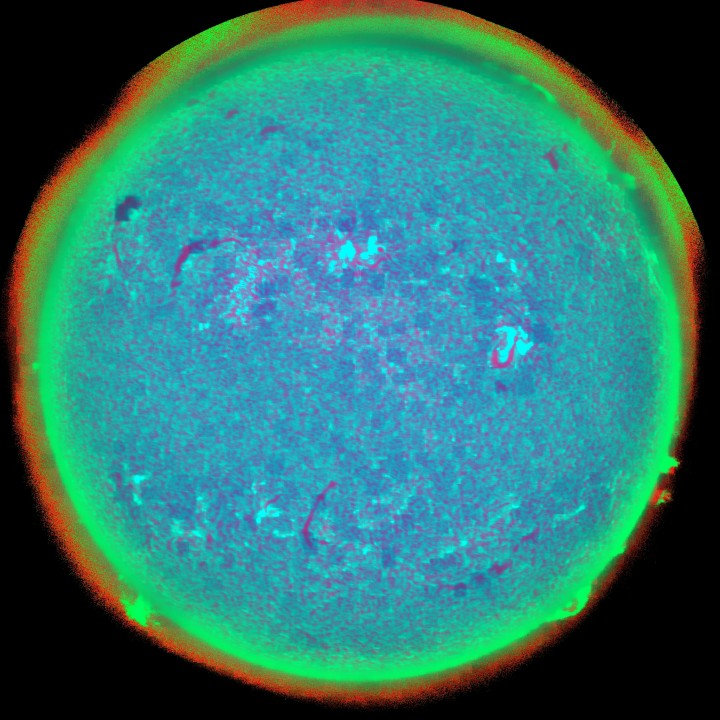
以下はコンペティションの学習・評価データとは別の、公開されている実際のGONG観測画像に対して自社モデル(YOLO + EdgeAttNet精密化)が推論により得られた検出結果です。
「生データ(自然なH-Alphaグレースケール)」と、「技術強調表示(検出パイプラインへの入力表現+黄色い検出輪郭ポリゴン)」を比較できます。各カードのボタンを押すと即座に切り替わります。
実観測データ切り替えビューア(ボタンを押して生データ ↔ カラー強調を比較)
03パイプライン — Instance-First 2段構成
検出器が個体候補を提案し、U-Net はその候補の境界だけを精密化する instance-first 構成を採っています。
instance-first とは — セマンティック手法との違い
セマンティック手法は「フィラメントらしい画素」をすべて 1 枚のマスクとして塗り、後から連結成分などで個体に割ります。 近接・接触する 2 本は塗りの時点で融合してしまい、正解が 2 個体なら片方が取りこぼし(FN)として二重に減点されます。 instance-first はこの順序を逆にし、YOLO11m-seg が最初から「個体そのもの」を独立した候補として検出してから、 U-Net は各候補の境界だけを個別に磨きます。個体の分離は最初の段階で確定するため、後工程を経ても崩れません。
図0: セマンティック手法は接触・近接する構造を単一のマスクとして統合してしまい、正解が複数個体の場合に検出漏れ(FN)や過大検出を招きます。一方、Instance-First 方式は検出段階で個体候補を独立して分離するため、後段の境界精密化を経ても正しい個体数が保持されます。
具体的な処理フロー
図1: 5 段構成。検出器が個体を提案し、EdgeAttNet(EG-MHSA 搭載)が微細構造を保持しながら境界を精密化する。
観測画像単位の Grouped 3-Fold。推論時は最高精度の Fold 2 単体を採用し、推論処理時間を約 1/3 に低減。
U-Net ボトルネックに EG-MHSA(エッジ誘導自己注意) を導入。主軸(spine)と微細側枝(barb)の幾何を保持。
個体間の画素重複を排他化し、コンペ公式準拠の圧縮 RLE フォーマットで出力。
NVIDIA A100 重い学習に使用
40 GB VRAM / 1,555 GB/s メモリ帯域
高解像度(2048px)全面像の検出器・セグメンテーション学習
A100 は T4 の
4.9× メモリ帯域
4.8× Tensor性能
NVIDIA T4 軽量処理に使用
16 GB VRAM / 320 GB/s メモリ帯域
前処理・後処理探索・パッチレベル推論
04評価の考え方 — IoU 0.5 の急峻な閾値特性(不連続ペナルティ)
この課題の評価には Panoptic Quality (PQ) を用います。予測と正解の対応は IoU > 0.5 で決まる仕組みです。
式中の TP / FP / FN?TP(True Positive)= 正しく検出できた個体。FP(False Positive)= 余分に検出してしまった個体。FN(False Negative)= 見逃してしまった個体。PQ の分母はこの3つで決まる。 の意味(タップ/ホバーで表示)
ポイントは、この閾値が連続的な配点ではなくステップ関数(不連続ペナルティ)になっている点です。 IoU 0.5 は Dice?IoU と同じく「重なり具合」を測る指標だが計算式が異なり、同じ形でも値がずれる(IoU 0.5 ≒ Dice 0.667)。分野によってどちらが使われるかが異なる。 0.667 に相当し、これをわずかに下回る予測は加点されないだけでなく、 FP として分母を増やし、正解も FN として二重に減点されます。逆に言えば、閾値の手前(IoU 0.3〜0.5)にある near-miss 予測の輪郭を精密化して合格ライン(IoU > 0.5)へ引き上げることが、スコア改善における重要なポイントとなります。
図2: 閾値の手前にある予測(near-miss)の輪郭を精密化し、合格ラインへ引き上げる改善がスコアへ最も寄与する。
05境界の精密化 — 内側削り込み(Shrink)が有効な理由 & EdgeAttNet(EG-MHSA)
検出器が出した候補の境界を精密化する際、候補の内側だけを削る方式(shrink)と、
候補を少し外側へ広げてから精密化する方式(guided)を検証しました。
図3: 検出候補は正解より広めに出る傾向があり、内側から削り込む精密化(shrink)がスコアを最も大きく押し上げる。
EdgeAttNet による微細側枝(barb)と主軸(spine)の保持
さらに、細い主軸から伸びる数画素幅の微細側枝(barb)を削り落とさずに維持するため、U-Net ボトルネックに Edge-Guided Multi-Head Self-Attention(EG-MHSA) を組み込んだ MediSegEdgeAttUNet(約35.2M パラメータ)を採用しました。
EG-MHSA の数理構造:
入力パッチ画像から軽量畳み込み E = σ(Conv3×3(Input)) によりエッジ事前マップを直接抽出し、ボトルネック解像度に双線形補間して射影(E' = Conv1×1(Interp(E)))。
このエッジ事前分布を Self-Attention の Query および Key に直接加算注入(Q = x + E', K = x + E')することで、フィラメントの輪郭・線状構造に対する自己注意重みを強調し、near-miss(IoU 0.3〜0.5)の境界欠損を大幅に抑制します。
実測による段階的スコア改善(全 707 観測 OOF?Out-of-Fold。交差検証で「学習には使わなかった」検証用データに対する予測結果のこと。未知データに対する汎化性能を客観的に評価する指標。)
| 検証フェーズ | 手法 | PQ スコア | 改善幅 (Δ) |
|---|---|---|---|
| ① YOLO Native | 生検出マスク(conf 0.26) | 0.3937 | — |
| ② 標準 U-Net 精密化 | 自社学習 U-Net による内側削り込み(shrink@0.45) | 0.4379 | +0.0442 |
| ③ 排他化ルールの適用 | drop_contained → area_asc(重なり解消) | 0.4426 | +0.0489 |
| ④ EdgeAttNet 精密化 | EG-MHSA 搭載(全 707 観測 3-Fold ブートストラップ検証) | 0.4454 | +0.0517(Δ+0.0028, 有意確率 99.8%) |
| ⑤ Kaggle 提出結果 | Public Leaderboard 採点(v52: EdgeAttNet + 単体モデル) | 0.39 | 444チーム中 13〜16位相当(推論時間を約 1/3 に短縮) |
※ ①〜④は同一指標(公式PQ)に基づき、全 707 観測の Out-of-Fold で評価した客観的実測値。④の EdgeAttNet 採用では、2,000 回のペア化観測クラスタ・ブートストラップにより 95% 信頼区間 [0.000915, 0.004756] を算出し、信頼区間にゼロを含まない統計的有意性を確認済み。⑤は Kaggle テストセットでの採点結果であり、3-Fold アンサンブルと同等以上の精度を単一モデルで実現(推論時間を約 1/3 に短縮)。
※ なお、パラメータ数を揃えた3構成の厳密なアブレーション(2026年8月31日、3-fold×2seed=18本学習)では、改善の主因は「attention容量の増加」であり、「エッジ誘導(edge prior)固有」の寄与は3-foldいずれでも確認されませんでした(3-fold全体PQ: base 0.4418 / EdgeAttNet 0.4429 / 標準MHSA 0.4432)。自社の主張を自社で再検証し、確認されなかった効果を正直に記録・開示する方針をとっています。
検証を重ねる中で、「大雑把に膨らませるのではなく、内側を丁寧に削り込み、注意機構を備えた精密化モデルで微細構造を保持する」という設計が、極めて細長い構造のセグメンテーションにおいて最も効果的であることが実証されました。
06開発状況 & 検証済みの技術的知見
検出・精密化パイプラインの確立にとどまらず、数多くの仮説検証と多重監査を経て、堅牢なモデル構造と工学的知見の蓄積を進めています。
| 項目 | 内容・検証結果 | 状態 |
|---|---|---|
| 個体検出(3-Fold) | YOLO11m-seg による個体候補の検出(imgsz 1280) | 完了 |
| EdgeAttNet 境界精密化 | EG-MHSA 搭載 U-Net による微細側枝・主軸の精密抽出(有意確率 99.8%) | 完了(正式採用) |
| 単一モデル推論の高速化 | Fold 2 単体推論により推論処理時間を約 1/3 に低減しつつ Public 0.39 を達成 | 完了(正式採用) |
| 評価基盤と多重監査 | 公式採点コード完全一致テスト & 2,000回ブートストラップ信頼区間算出 | 完了 |
| pseudo-labeling 検証(負の結果) | 外部画像追加によるモデルバイアス増幅を 2-Fold 独立検証で立証(汎化に寄与しないデータ拡張を棄却) | 検証・棄却完了 |
| 他アーキテクチャ比較 | RF-DETR-Seg(432px / 768px)検証(高解像度 YOLO+EdgeAttNet の優位を確認) | 検証完了 |
| 3-Fold アンサンブル検証(負の結果) | V53 提出で Public LB 0.38(単体モデルの 0.39 より悪化)。アンサンブル統合は効かないことを refiner 変更後も再確認 | 検証・棄却完了 |
| matched-parameter アブレーション | base / 標準MHSA / EdgeAttNet の3構成×3-fold×2seedを同一条件で学習し、エッジ誘導固有の寄与を分離検証(attention容量一般は有効、edge prior固有の効果は未確認) | 検証完了 |
| リーダーボード健全性分析 | テストセット180枚中139枚(77.2%)が公開MAGFiLOと一致するリークを確認し、上位クラスタ(0.55〜0.56)の追走を中止。規約適合の誠実な評価を継続 | 分析完了 |
| 追加改善レバーの検証(負の結果) | refiner入力のマルチチャンネル化(Δ−0.0206)・スケルトンによるギャップ閉合(効果ゼロ、独立2-fold一致)を棄却。EMA重み平均は微小改善(+0.0005)で検証継続 | 検証・棄却完了 |
| コンペティション最終提出 | 4ページ技術報告書(Overleaf)草稿完成 & 再現性リポジトリ整備(2026年11月締切) | 進行中 |
07開発方針 & 科学・実運用へのロードマップ
当社では、評価スコアの表層的な最適化に終始するのではなく、「客観的な指標の数理的理解・厳密な多重監査・高い再現性の徹底」を開発の基本方針としています。
- 評価指標のテスト — 公式採点コードとの一致を乱数 200 ケースで機械的に検証
- 単一 Fold の過学習を排除 — 単一 Fold だけで良好に見える手法(選択バイアス)を多重 Fold 監査で検出し、全 Fold で一貫して改善する手法のみを採用
- 負の結果(Negative Results)の開示 — 有効でなかった試み(pseudo-labeling・3-foldアンサンブル・マルチチャンネル化・ギャップ閉合など)も理由とともに記録し、工学的根拠を明確化
- リークへの不介入 — テストセットと公開データセットの重複を発見しても、規約で禁止されるリーク利用は行わず、誠実なモデルとしての評価を継続
- 科学・実運用価値(Space Weather)への接続 — 単なる PQ スコアにとどまらず、太陽物理学における「主軸(spine)の連続性」「側枝(barb)の保持」「磁場カイラリティ(捻れ方向)」の解析(S0/S1 ゲート)へと展開