BIOHUB CELL TRACKING細胞の検出と系譜追跡(3D + 時間 顕微鏡データ)Cell Detection & Lineage Tracking in Developing Embryos (3D + Time)
発生中の胚を撮影した 3D + 時間の顕微鏡データから、細胞核を検出し、時間方向につないで系譜を再構成する 研究モジュールです。1 フレームあたり数千個の核が動き、しかも分裂して 1 個が 2 個になるため、 単なるフレーム間対応づけでは追跡が破綻します。Kaggle Biohub - Cell Tracking During Development の課題設定に沿って開発しています。データは Royer Group が取得した実際のゼブラフィッシュ胚の顕微鏡撮影で、 公開されている細胞追跡データセットとしてはアノテーション数で最大級(CC0 ライセンス)。 2025 年に Nature Methods で発表された細胞追跡アルゴリズム「Ultrack」の成果を踏まえたコンペティションです。
細胞の検出と系譜追跡
検出して終わりではない。「どれとどれが同じ細胞か」「どこで分裂したか」までを 1 つのグラフとして出す。
出力は画像ではなくグラフです。各時刻の核が node、時刻をまたぐ同一細胞の対応が edge、 1 つの親から 2 本の edge が出れば 分裂。検出誤差がそのまま系譜の断絶に伝播するため、 検出・連結・整合性の 3 段をそれぞれ独立に評価しています。
- 検出Temporal 3D U-Net?3D空間と時間軸を同時に扱う畳み込みニューラルネット。時系列のボクセル特徴から核の中心座標と確信度を抽出する。。実 Zarr?大規模な多次元配列データをチャンク圧縮して高速に読み出せるストレージ形式。本タスクの巨大時系列画像の保管に使用。 画像 199 本を監査し 179 本で学習。
- 連結edge Transformer?隣接フレーム間で検出された核同士のアテンション(関連度)を計算し、同一細胞である確率を推定する自己注意機構。 が対応を推定し、ILP?整数計画法(Integer Linear Programming)。1子1親制約や最大2分岐などの追跡ルールを全体最適として一括充足する最適化手法。 が追跡制約を課す。
- 再現性重み SHA256 の固定と、設定 84 項目の機械抽出。
00公開ベンチマーク課題における検証スコアと参加規模
本コンペティションは、Kaggle 公式集計で 4,478 名・3,947 チームが参加し、総提出数 95,438 件に達した発生生物学 AI コンペティションです(Kaggle 公表値、2026年10月3日時点の最終値)。 ゼブラフィッシュ胚の 3D+時間ボリューム(1 フレームあたり数千個の細胞核)を追跡し、細胞分裂による分岐までをグラフ構造として再現する設定です。
3D 時系列追跡タスクの技術的要件とパイプライン設計
本コンペティションは、参加登録 13,351 名 に対し、3,947 チーム(4,478 名) がモデルを提出した大規模な大会です(総提出数 95,438 回)。 3D 時系列データの処理や追跡グラフの生成など、以下のような複合的なパイプライン設計が求められます。
- ① 巨大な 3D+時間 Zarr データのハンドリング — 展開後 81GB 超、数万ファイルに及ぶ 3次元時系列データを、RAM や GPU メモリの枯渇(OOM)を起こさずストリーミング処理する設計。
- ② 検出・連結・系譜グラフの 3 段複合パイプライン — 3D U-Net(ボクセル検出)→ edge Transformer(フレーム間対応)→ ILP 整数計画法(大域追跡制約)を組み合わせた構成。
- ③ 12 時間の制限下での推論実行 — Kaggle の提出環境(GPU 12 時間制限)内で、テスト 3D ボリュームの推論・後処理・グラフ生成を時間内に完走させる構成。
- ④ 出力データ契約(node / edge CSV) — 数十万行に及ぶ CSV 出力において、ID 連番・次フレーム方向への有向辺・出力フォーマット適合などの整合性チェック。
単体モデル(Public Score 0.741)によるパイプラインの動作確認と holdout 20 本での閾値校正基盤の検証を行った上で、 Two Seeds Logit Blend のアンサンブル構成を検証し、Public Score 0.912 を確認しました。 その出力後処理パラメータを 1 要因ずつ変える ablation(要因分離実験)で最適化して 0.914 に到達した後、 終盤に登場した別の公開手法(Public 0.953 系)にも同じ後処理最適化を適用し、 Public Score 0.955(416位)で終えました。順位を決める Private Score は 0.920・390位 (3,947チーム中、上位 約9.9%)で、銅メダル(上位10%)を獲得しました(Kaggle 公式の最終順位)。 上位陣は Public 首位 0.978・10位 0.971、Private 首位 0.977・10位 0.948 です。
Kaggle 公式の参加内訳(2026年10月3日時点・最終): 13,351 Entrants(参加登録者)/ 3,947 Teams(4,478 名、計 95,438 Submissions)。
図: Biohub 追跡課題の Public スコアでの位置づけ(最終 Public LB・2026年10月3日時点)。公開手法の後処理最適化で 0.912 → 0.914 → 0.955 と積み上げ、Public 416位。順位を決める Private では 0.920・390位(3,947チーム中、銅メダル)。
アプローチの要点 — 4つの設計方針
Detection-to-Graph 3 段ハイブリッド構成
単一 End-to-End モデルに頼らず、Temporal 3D U-Net(検出)→ edge Transformer(連結)→ ILP(大域整合性) に責任を分割し、各段を独立に監査・検証。
少データ環境に対する低容量 bagging
実質 2 胚(179本)という極少データに対し、巨大モデルの過学習を避け 低容量モデル(約208万)の独立 2 seed 融合 を採用。
連結先を壊さない非対称融合
検出はほぼ均等(0.475)に無条件融合し、連結は Top-1 が一致し迷っている時のみ最大 0.15 しか混ぜない保守的設計で誤連結の抑制を図る。
指標操作を排した生物学的に実直な追跡
評価指標の計算特性を利用した画像外ノードの人工的挿入(0.950)を採用せず、実空間内での分裂復元(DeepCenterゲート) に注力。
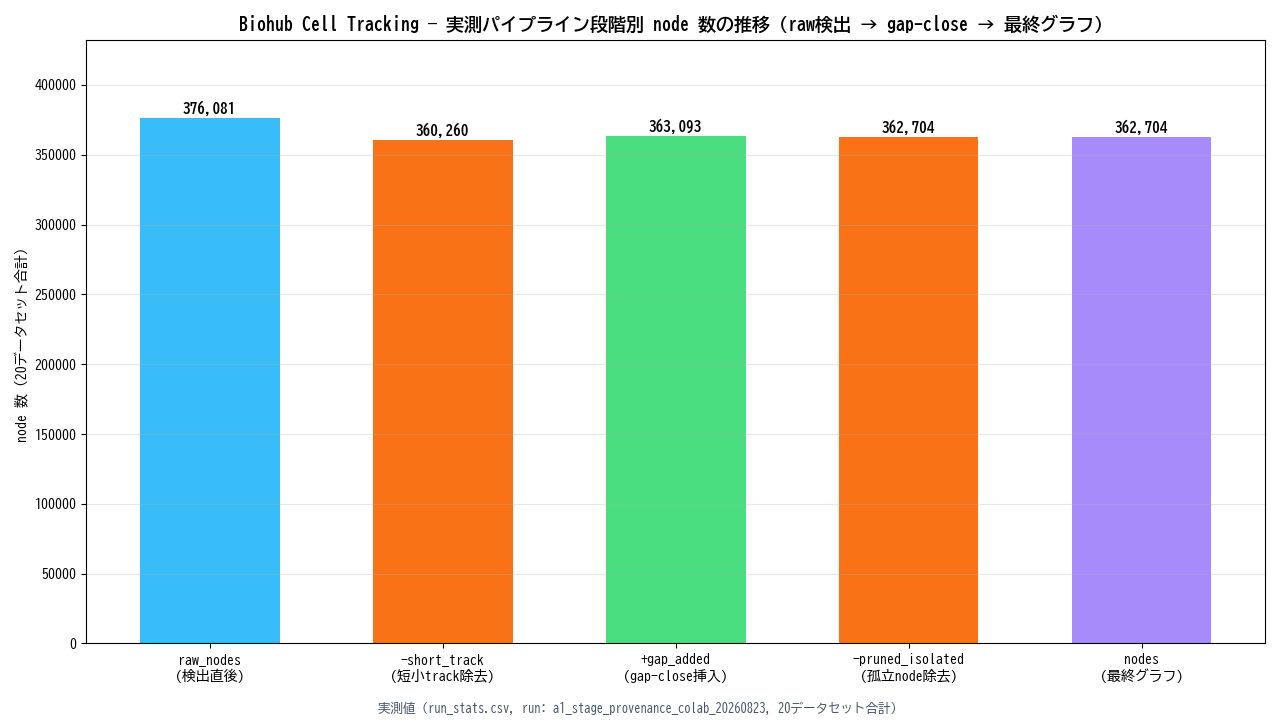
実測パイプライン統計 — holdout 20データセットのグラフ規模と分裂検出
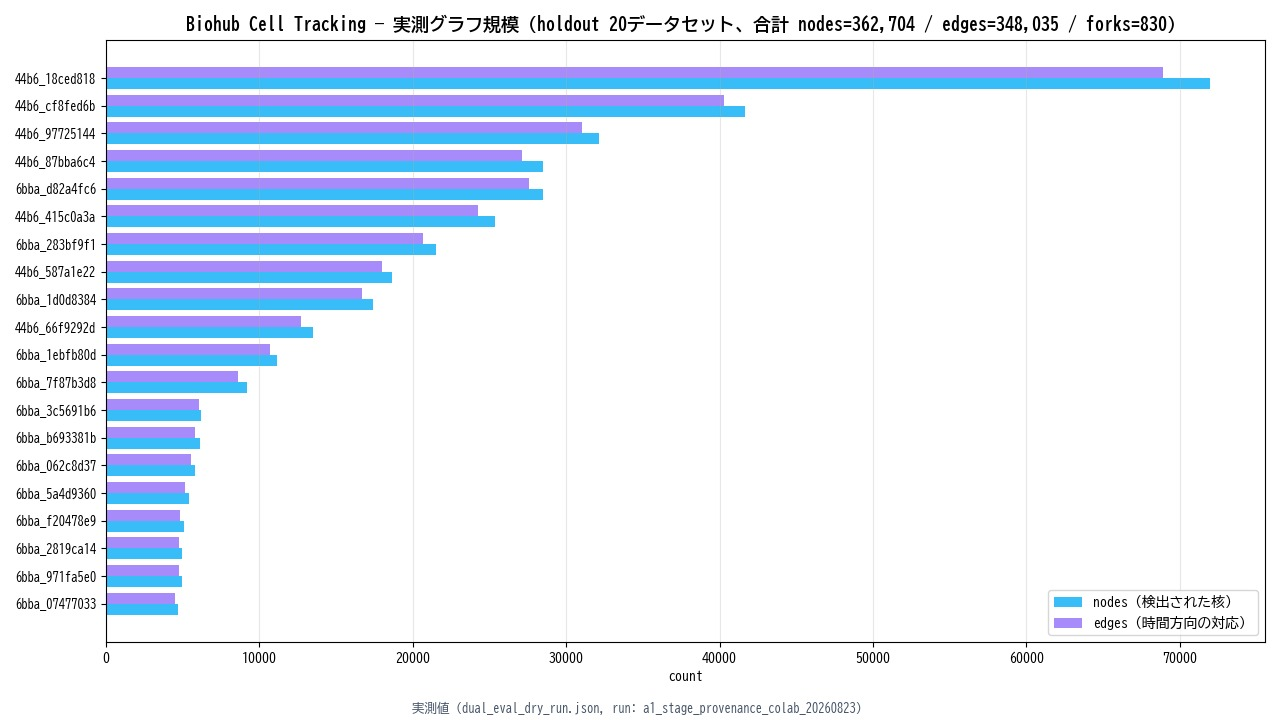
実測グラフ規模(nodes / edges)
Phase A1 holdout 20データセットにおける実測パイプライン統計(dual_eval_dry_run.json)。1データセットあたり数千〜7万超のnodes(検出核)と、それらを時間方向につなぐedgesをグラフとして扱っている規模がわかる。
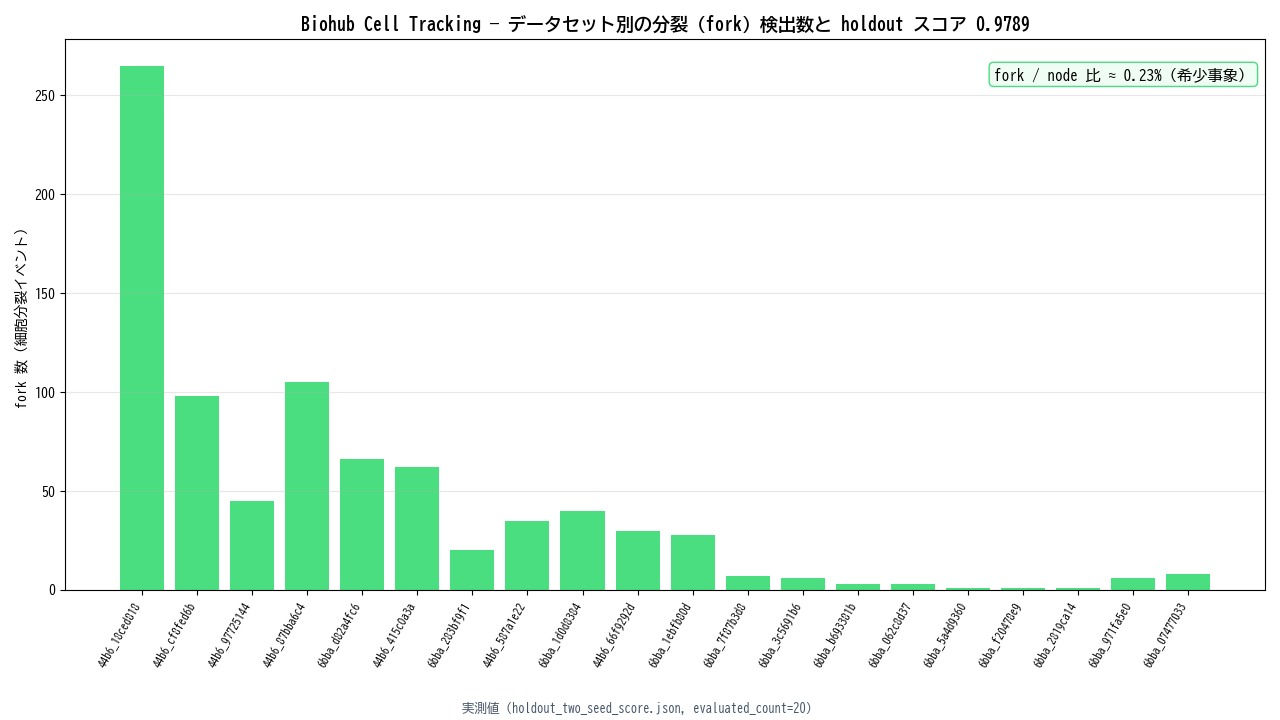
分裂(fork)検出数と過去の raw GEFF 再評価
fork数は後段処理後の提出グラフの統計で、全nodeに対し約0.23%です。一方、図中の0.9789は過去の raw GEFF 再評価スコアで、名目holdoutの20動画すべてが第2seedの学習データと重複しています。最終グラフのスコアでも独立評価ではありません。出典はa1_stage_provenance_manifest.jsonのraw_geff_scoreと、別のdual_eval_dry_run.jsonの提出変換統計です。
動的可視化(概念アニメーション) — 3D+時間ボリューム内の細胞追跡と分裂(Division)の再構成イメージ
研究者向け解析ワークステーション画面の概念アニメーション(合成データ、実推論結果ではありません)
3 段推論モデル(3D U-Net 検出 → edge Transformer 連結 → ILP 整合性制約)を研究者が検証・探索する際の画面イメージを、数理モデルで生成した合成データにより再現した概念アニメーションです。実際のモデル推論結果ではありません。 視点を安定させた 3D ボックス空間で、細胞核の移動軌跡(ネオンストリームライン)と細胞分裂(Fork 2 分岐)が時間とともに再構成されていく様子を可視化しています。
DIV #53, DIV #132...)は「細胞分裂が起きた瞬間」です。1 個の親細胞が分裂して 2 本の娘細胞のネオン軌跡へと分かれ、胚表面を滑り降りる様子を追跡。
0.96, 0.98...)をリアルタイム表示。
Founder #01)が Fork 1(Y字分岐)で 2 個の娘細胞へ分裂し、さらに 4 個へと増殖していく家系図を表現。
[1] 3D U-Net、[2] Transformer、[3] ILP は 3 段パイプラインの処理段階を表す概念ラベルであり、実測の検出数・整合性判定ではありません。
1 フレーム間隔 \(\Delta t \approx 2.5\) 分。全 50 フレームで約 125 分(受精後 1.2h 〜 3.3h 相当、胚盤胞〜原腸形成期のエピボリー運動)。
\(500\,\mu\text{m} \times 350\,\mu\text{m} \times 270\,\mu\text{m}\)(ゼブラフィッシュ初期胚の長径・短径・深さ)。
XY: \(0.406\,\mu\text{m}\)(4倍間引き推論時 \(1.625\,\mu\text{m}\))、Z: \(2.0\,\mu\text{m}\) スライス間隔。
- 生物学的流動(エピボリー運動): 原腸形成期において動物極(Animal Pole / 上部)から植物極(Vegetal Pole / 下部)へ向けて細胞群が胚ドーム表面を滑り降りる一方向性の流動(Epiboly Stream)および正中線への収斂伸長(Convergent Extension)のベクトル場を数理モデル化して再現しています(円旋回ではなく、本物の発生流動に準拠)。
- 系譜トポロジー(GEFF / ILP 整合性): 「1細胞は最大1親」「分裂(Fork)時は2つの娘細胞へ分岐」というグラフ構造ルールを満たすよう整数計画法で充足。
- データ仕様の位置づけ: この動画自体は
np.random.seed(512)による完全な合成データで、1 胚あたり 81GB 超の Raw Zarr ボリュームから 3D U-Net + edge Transformer + ILP で推論する実測パイプラインの空間寸法・時間解像度・処理フローを模した、あくまで概念デモです。実際の検出数・整合性判定の値ではありません。
01何を当てるのか — 出力はグラフ
入力は zarr 形式の 3D 時系列画像、正解ラベルは geff?Graph Exchange Format for Families。細胞系譜グラフをノード(各時刻の核)とエッジ(時間方向の接続)で記録する標準データ形式。 形式の追跡グラフです。
提出物は 1 枚の CSV ですが、その中身は 2 種類の行からなります。
node 行が「時刻 t の座標 (z, y, x) に細胞核がある」、
edge 行が「node A と node B は同一細胞である」を表します。
図1: 出力は node と edge からなる系譜グラフ。検出漏れ(赤破線)は 1 個の失点では済まず、そこから先の系譜をまるごと断ち切る。
スコアは node・edge・division の内訳を持ちます。つまり核を見つける精度、正しくつなぐ精度、 分裂を当てる精度が別々に効きます。分裂は全 edge のごく一部しか占めないため、 平均的な精度を上げるだけでは division の取りこぼしが残りやすい構造です。
02パイプライン
検出と連結を分離した 2 段構成です。U-Net が時刻ごとの核候補と特徴を出し、 Transformer が隣接フレーム間の対応を推定、最後に ILP(整数計画)が 「1 つの子は 1 つの親を持つ」「分裂は最大 2 分岐」といった追跡制約を一括して課します。 ただしこの推論構成では、下の図の「検出」「連結」の箱はそれぞれ 1 個のモデルではありません。 独立に学習された 2 つの seedを融合したものであり、後処理にはさらに別アーキテクチャの第 3 のモデル(DeepCenter)が ゲートとして挟まります。詳細は 05 節で扱います。
図2: 検出 → 連結 → 整合性の 3 段。後処理は新しい細胞を作らず、既存の系譜の切れ目を保守的に補修する役割に限定する。
03実データ学習と、自社モデルの実績
開発初期には、パイプラインの動作確認用データで学習したものを性能とみなしかけた失敗があります。
以降は公式の train/*.zarr と同名の train/*.geff のペアだけを本学習に使い、
対応数・分割・動画名をログと JSON に残す運用へ変更しました。
| 項目 | 本数 | 用途 |
|---|---|---|
| 監査で対応が取れた実データ | 199 | — |
| 学習 | 179 | モデル学習 |
| holdout?モデル学習から除外し、検出閾値の最適化・校正専用に確保した20本の検証データ。 | 20 | 検出閾値の校正 |
| test | 4 | 提出用推論 |
撮影群は 44b6 が 71 本、6bba が 128 本。展開後で約 81.59 GiB、24,886 ファイルという規模のため、
Colab では毎回ダウンロードし直さず、Drive 上の ZIP を各 VM のローカル SSD へ展開して学習しています。
検出閾値は holdout で決める
検出閾値は Public Score を見ながら動かすのではなく、学習に使っていない holdout 20 本で選びました。
| 検出閾値 | holdout score | 評価本数 |
|---|---|---|
| 0.80 | 0.6779 | 20 |
| 0.90 | 0.6882 | 20 |
| 0.97 | 0.7021 | 20 |
この閾値 0.97 で 4 本の test を推論し、Kaggle hidden test の再実行で Public Score 0.741 を得ました。 これが自社で学習したモデルの実績です。提出 CSV は 339,926 行(node 188,889 / edge 151,037、約 17.39 MB)で、 列順・連番 ID・4 dataset の網羅・self-loop の不在・edge が次フレーム方向を向くことを機械検査しています。
score=nan のまま進行していた事例がありました。以降は「予測 20 本と正解 20 本の対応が過不足なく一致することを検証条件とする」
ように改修しています。予測出力の完了と評価パイプラインの正常稼働を分離して検証する重要性を確認しました。
04公開ベースラインの再現 — 0.912 の構成
単体モデル(0.741)からさらなる改善を図るため、公開されている先行アプローチ・手法を調査しました。そのうち
Two Seeds Logit Blend(公開者: Pilkwang Kim)は人工ノードによる指標操作を含まないアプローチだったため、
Kaggle 上で Copy & Edit して再実行し、Public Score 0.912 を確認しました。
| 提出 | Public Score | 位置づけ |
|---|---|---|
| 初期検証モデル(Version 29) | 0.741 | 単一 seed での学習・校正 |
| Two Seeds Logit Blend(Version 1) | 0.912 | 公開手法の再現。改善分離の出発点 |
| 後処理最適化構成(提出 55786052) | 0.914 | 公開手法の後処理を要因分離実験で最適化(09節) |
| 最終提出(0.953 系再現+後処理調整) | 0.955 | 最終成績: Public 416位/Private 0.920・390位(銅メダル)。終盤の別公開手法への同手法適用。Private は最終選択した別提出の値(09節) |
05複数モデル推論の内訳とパラメータ数 — 小型モデル群の実態
0.912 は 1 個のモデルの出力ではありません。独立に学習された3 つのニューラルネットワークを、 推論時に組み合わせて出力しています。3 つとも学習は事前に完了しており、この再現実行時においては パラメータの更新は行わず、純粋な推論(forward pass)とアンサンブルを行っています。
two_seeds_latest.py が読み込むモデルは、独自定義ではなく support pack 同梱の
predict_unet_transformer.py(自社の 0.741 パイプラインと同一の UNetNodeTransformer クラス、host 提供 starter kit 系譜)です。
デフォルト設定を実際にインスタンス化し、パラメータ数を精査しました。
| 構成要素 | チャンネル幅/構造 | パラメータ数 | 役割 |
|---|---|---|---|
| TemporalUNet3D | 検出用エンコーダ・デコーダ(3段: 32→64→128ch) | 約 150 万 | 3D 時系列からの核候補・ボクセル特徴抽出 |
| Transformer 部のみ | hidden_dim=128, 4 heads, 4 blocks | 約 58 万 | 時間方向のノード間アテンション・edge 特徴量計算 |
| UNetNodeTransformer(主モデル) | UNet(150万)+ 検出 head + edge Transformer(58万) | 約 208 万 | 検出・連結の基準出力(seed A) |
| 第 2 seed | 主モデルと同一構造・別乱数種で独立学習 | 約 208 万 | 検出 logit を無条件融合、edge logit を条件付き融合(seed B) |
| DeepCenter ゲート | 別系統の 3D U-Net(base_channels=24、4 段構成) | 約 315 万 | 後処理段で分裂の見落としを追加のみで復元 |
| 推論に使う実質合計(主モデル + 第2 seed + DeepCenter) | 約 730 万 | 3 モデルの推論を直列・並列に組み合わせて 1 本の submission.csv を出力 | |
比較として、同じ 3 段構成をもっと標準的な nnU-Net 的な 5 段(32→64→128→256→320ch)に増やしただけで、 UNet 部分単体が約 1,730 万パラメータに達します。それだけで現行の全アンサンブル合計(約 730 万)を 2 倍以上上回ります。 モデルサイズとしては軽量な構成となっています。
downsample=(1,4,4)?Z方向はそのまま、XY方向を縦横1/4(面積比1/16)に間引いて処理する設定。実効XY解像度が1.625µm相当に落ち、密集した細胞核の区別が困難になるトレードオフがある。 で XY 方向を 4 分の 1 に間引いています。
これにより実効 XY 解像度は約 1.625 µm 相当まで落ち、Z 解像度と同程度になります。
モデルの表現力以前に、この間引きによる解像度損失が物理的な限界を与えています。
インタラクティブな構造・パラメータ可視化ツール
各モデルの内部レイヤー、テンソル形状、パラメータ内訳、粒子の流れる推論データフロー、二 seed 融合の非対称比率を視覚的に操作・確認できる専用ビジュアライザーを用意しました。
二 seed 融合の非対称性(検出と連結)
主モデルと第 2 seed の組み合わせ方をさらに見ると、「2 つの seed を混ぜて精度を上げた」と 一言で説明される手法の実装は検出側と連結側で融合の強さも条件もまったく違います。これは公開ノートブックの ローカル監査コピーから設定 84 項目を静的に抽出し、実行時の値と突き合わせて確認しました(76 項目を照合、不一致 0)。
図3: 検出側は無条件のほぼ均等な融合。連結側は「両 seed が同じ相手を選び、かつ迷っている」ときだけ、しかも最大 0.15 しか混ざらない。
連結側の融合が起きるのは両 seed の最有力候補が一致するときだけです。 同じ添字が最大である 2 つのベクトルを混ぜても最大の位置は動かないため、 この融合はどの細胞についても「つなぐ相手」を変えません。変わるのは確信度の大きさだけで、 それが edge 候補の採否(閾値 0.48)と ILP のコストに効きます。
つまり 0.741 → 0.912 の改善は、連結の付け替えではなく 検出側の融合と、支援パック側の後処理群(DeepCenter ゲート、ILP、gap close)に由来する可能性が高い、という仮説が立ちます。
06モデル容量拡大の検証 — 「大きくすれば精度は上がるのか?」
現行モデルが約 730 万パラメータの小型構成であると分かると、「モデルを大型化(スケールアップ)すれば精度は上がるのか?(モデルサイズ拡大が精度向上に直結するのか)」という疑問が生じます。 これについて、以下の 3 つの視点 から検討しました。
| 視点 | 検討内容 | 分析結果と示唆 |
|---|---|---|
| 1. 過去の伸びの要因 | 0.741 → 0.912 の伸びはモデルサイズ拡大に起因するか? | 設定監査で特定済み。改善は検出 logit ブレンド(アンサンブル)と後処理(DeepCenter ゲート、ILP、gap close)によるもので、単体モデルの表現力拡大ではない。「モデルを大きくすれば精度が上がる」という仮説は過去実績からは支持されない。 |
| 2. データ量の制約 | 少データ環境で大モデルを学習して汎化精度は出るか? | 実訓練データは 179 本だが実質 2 胚由来。この規模で巨大モデルをフルスクラッチ学習すると過学習リスクが高まります。「独立 2 seed の低容量モデルによるアンサンブル(bagging?Bootstrap Aggregating。複数の独立したモデルの出力を平均化してバリアンス(過学習)を減らすアンサンブルの標準的な手法。)」は少データに対する定石的・合理的な判断。 |
| 3. 計算予算とコスト | 推論時間・学習時間の制約はあるか? | Kaggle 制約(GPU 12 時間以内)に対し現行推論は約 26 分で完走。推論時間の余裕は十分にあるが、A100 による大規模な再学習には別途高い計算コストが発生する。 |
判断と開発方針
このプロジェクトの実測方針(推測で直さず実験で確かめる)に照らすと、単体モデル容量の拡大は優先順位を低めに置くべきというのが現在の判断です。 ロードマップ(Phase 1: 閾値・ブレンド見直し、Phase 2: 後段グラフ精緻化、Phase 3: division 特化データ、Phase 4: 独立 seed 追加)はすべてこの優先順位に沿って設計されています。
有望な代替仮説 — 解像度損失の緩和:
モデルを修正する場合、単純なチャンネル幅拡大よりも先に、downsample=(1,4,4) の解像度損失を緩和する(間引き率を下げる) 方が筋の良い候補です。
Jaccard 指標の node matching は 7 µm 半径基準であるため、密集した細胞核が 4 倍間引きで潰れて区別不能になる問題の方が、単純なチャンネル幅不足よりも疑わしい失敗要因です。
これも推測で確定させず、Phase 0 の holdout 評価基盤で実測して確かめます。 Phase 4(独立 seed 追加=アンサンブル拡大)の一部として、「高解像度/大型の 3 本目の seed」を追加してアンサンブルする という位置づけが自然です。
07評価指標の計算特性を利用した操作手法を採用しなかった判断
監査した公開手法の中には、表示スコアが 0.950 前後とさらに高いものもありました。 しかし中身は、通常の追跡結果に加えてデータ範囲外の人工ノードと人工的な接続を大量に追加するものでした。
図4: 表示スコアは右の方が高い。ただし右は評価指標の性質を突いた操作で、細胞追跡としての正しさは向上していない。
本モジュールではこれを採用していません。研究目的と整合しないうえ、 指標の穴に依存した解は隠れテストや最終評価で頑健である保証がないためです。 Public Score だけを指標としないという方針を、記録として残しています。
08再現性への配慮
このタスクで繰り返し問題になったのは、モデルそのものより「どの重みで、どの設定で動いたのか」が曖昧になることでした。 Kaggle の Dataset は表示名が変わり、Input はコード外の状態として持たれ、ノートブックは手編集で少しずつずれていきます。 そのため実績値そのものを機械検査の対象にしています。
- 重みの同一性 — 主モデルと第 2 seed の重みは SHA256 を実装内に固定。不一致なら実行を停止するため、成功した実行が使った重みは一意に特定できる
- 設定の機械抽出 — 実行環境の設定 84 項目をノートブックを実行せず静的に解決し、実行時の値と照合(76 項目、不一致 0)
- 無効な設定の検出 — 環境変数の上書きが「読み出しより後」に置かれて無効化されていないかを機械検査
- 文書の検査 — 主要実績値・リンク・実験台帳への登録漏れ・生成物の陳腐化を検査するツールを用意し、実績値が文書から消えたら失敗させる
- ノートブックは生成物 — 手編集せず生成スクリプトから作り直す
検証の副産物として、設定表の値がそのまま効くとは限らないことも分かりました。 たとえば「2 フレーム跨ぎの補修」に見える設定は、実行時に 1 に固定され直すため、 1 と 2 のどちらを指定しても結果が変わりません。設定ファイルの見た目ではなく、 実際に読まれる値を確認する必要があります。
09改善要因の分離 — 実施結果と現行構成
公開再現ベースライン(0.912)は、モデル・seed・融合・ILP・後処理を同時に変えた結果であり、 どれがどれだけ効いたのかが分離できていません。そこで 1 回の提出で 1 つの仮説だけを変える ablation?要因分離実験。複数要素が同時に変わっている状態から、特定の要素(検出融合など)だけを1つずつ外してその個別の寄与度を測定する手法。 を設計・実行しました。
| arm | 変えるもの | 確かめたいこと |
|---|---|---|
| A0 | なし(対照) | 0.912 が再現するか。ここが再現しなければ以降は解釈できない |
| A1 | 検出側の融合を無効化 | 検出融合の寄与。仮説では最も下がる |
| A2 | 連結側の融合を無効化 | 連結融合の寄与。仮説では下がり幅は小さい |
| A3 | 両方を無効化 | A1 と A2 の和から外れれば、両者に交互作用がある |
| B1 | 中心事前分布のゲートを既定へ | 後処理側の寄与 |
設計にあたって、実装上客観的な比較を阻害する交絡要因が 2 点判明しました。 どちらも「実行は成功し、スコアも出るが、測っているものが違う」種類の失敗です。
図5: どちらも実行は成功しスコアも出る。だから気づきにくい。arm ごとに設定の挿入位置を自動で決め、実行ログで反映を確認してから結果を記録する。
特に留意点 2 は重要で、設定の上書き位置が不適切であるとベースラインと同一の結果が出力されます。 それを「融合は効かなかった」と読むと、正しい実行から誤った結論を導いてしまいます。 そのため各 arm には挿入位置と、実行ログ上での反映確認手順を必ず添えています。
実行結果 — 出力後処理の要因分離・第1キャンペーン(2026年8月後半)
出力後処理側のパラメータを Kaggle 提出で 1 要因ずつ変えて実測しました。
その結果、ILP division 重み 0.67・motion relink 停止・safe divisions 停止・出力 edge 上限撤廃・line-fit 0.8 維持
の組み合わせが Public Score 0.914 に到達し、第1キャンペーンのデプロイ構成として採用されました(提出 55786052)。
| 試行した要因 | 結果 | 判定 |
|---|---|---|
| ILP division 重み 0.67(既定 1.00) | 0.914(1.00 は 0.902) | 採用 — division 制約の緩和が有効 |
| safe divisions(人工救済ノード)off | on は 0.909 に低下 | 採用(off) |
| 出力 edge 上限の撤廃 | 0.914(同点・holdout で最良) | 採用(off) |
| line-fit(座標平滑化)off | holdout 最良だが Public 0.905 | 不採用 — 重み 0.8 を維持 |
| 検出閾値 0.94(既定 0.96875) | 0.913 | 不採用 |
| 第1キャンペーン採用構成(Public 0.914) | 値 |
|---|---|
| ILP division 重み | 0.67 |
| motion relink / safe divisions / 出力 edge 上限 | すべて off |
| line-fit 重み | 0.8 |
| gap-close / min-track | 5.8 µm(密度適応)/ 6 |
| 検出閾値 / KEEP_DIVISION_COMPONENTS | 0.96875 / on |
この過程で 2 つの重要な教訓が得られました。 第一に、固定 holdout 上の replay 順位と Public 順位が入れ替わる事例が確認されました (line-fit off は固定 holdout で最良 0.9818 ながら Public では 0.905)。 hidden test 候補は Public 実測でしか確定できません。 第二に、後の来歴監査で固定 20 動画の holdout が第 2 seed の学習対象と全 20 本重複していることが判明しました。 replay は設定比較の回帰指標としては有効ですが、未学習データに対する独立評価(holdout/OOF)ではありません。 これは Public 0.914 自体の無効化ではなく、ローカル評価の独立性の問題です。
並行して、自社重みの再学習ライン(P2)も進行中です。fold0 の scratch baseline 学習を停止点まで実行し、 公式 outer 評価で 0.7748(現行後処理適用で 0.7807)を確認しました。 公開手法の重みに依存しない自社モデル側の改善は、このラインで継続検証します。
第2キャンペーン — 0.953 系公開手法への適用と最終順位(2026年9月後半)
コンペ終盤、上位帯が 0.97 前後まで上昇する中で別の公開手法
(anvithpothula/biohub-0-953-lb-original、Public 0.953)が出現しました。
これを同一条件で bit-exact に再現(0.953 を確認)した上で、第1キャンペーンと同じ方針で
後処理ノブを 1 要因ずつ試行しました。
| 試行した要因(0.953 系ベース) | Public Score | 判定 |
|---|---|---|
| READMIT_MIN_SCORE 0.965 → 0.90(単一ノブ) | 0.955 | 採用 — 以降の組み合わせのベース |
| READMIT 0.90 + DET_THRESHOLD 0.955 | 0.955 | Public 最高(0.95598・416位) |
| READMIT_MIN_SCORE 0.965 → 0.80(単一ノブ) | 0.954 | 最終選択 — Private 0.920 で順位決定 |
| READMIT_RADIUS_UM 4 → 6 µm | 0.954 | 不採用 |
| DET_THRESHOLD 0.965 → 0.955(単独) | 0.954 | 単独では不採用 |
| READMIT 0.90 + MIN_TRACK_LEN 6→5 | 0.954 | 不採用 |
| OUTPUT_MIN_TRACK_LEN 6 → 4(単独) | 0.952 | 不採用 |
最終リーダーボードでは Public Score 0.955・416位、順位を決める Private Score は 0.920・390位 (3,947チーム中、上位 約9.9%)で、銅メダルを獲得しました。Public 首位は 0.978、Private 首位は 0.977。 Private の順位は、最終選択した提出のうち READMIT_MIN_SCORE 0.965 → 0.80 版(Public 0.954)の Private Score で決まりました (上表の Public 最高 0.955 提出[READMIT 0.90+DET_THRESHOLD 0.955]は Private 0.921 でしたが、最終選択に含めていませんでした)。 同スコア帯には同系の公開手法を利用した提出が密集していました。 なおこの結果も公開手法の推論出力が基盤であり、自社学習モデルの最終成果ではありません (自社重み側は単体 0.741/P2 fold0 公式評価 0.7748)。