Kaggle Hyperspectral Object Detection Challenge 2026
16バンド可視光ハイパースペクトル画像による物体検出と材質識別の検証
リンゴとプラスチック製リンゴ、本物の車とミニカー、生卵と木製卵など、可視光カラー(RGB)空間では色や輪郭が類似している対象について、460 nm 〜 600 nm の 16 バンド可視光ハイパースペクトル画像から得られる分光反射率シグネチャを手がかりに、物体検出および材質分類を行うパイプラインを構築・検証しています。
XIMEA 4×4 センサ
全18クラス(実物/樹脂/木製/玩具)
16ch テンソル入力へ拡張
実運用向け並行開発
1. 課題設定と分光識別の意義
一般的なカラーカメラ(RGB 3チャンネル)による物体検出は、対象の「幾何学的輪郭(形状)」と「見かけの色」を主な識別根拠とします。一方で、食品選別、リサイクル原料の仕分け、製品検査などの現場では、外見上の色や形状が酷似していても材質が異なる対象を識別することが求められる場面があります。
- 生鮮食品と模造品(サンプル・樹脂製品): リンゴ(
apple)とプラスチックリンゴ(apple_plastic)、バナナとプラスチックバナナ。 - 実車とミニカー・模型: 実車(
car)と玩具(car_toy)の識別。 - 材質の異なる同一形状物: 生卵(
egg)、プラスチック卵(egg_plastic)、木製卵(egg_wood)。
これらの対象は、波長ごとの反射率特性(460 nm〜600 nm の分光シグネチャ)に固有の差異が現れます。OptiScan-HSI では、デモザイク処理によって復元した 16 バンドのテンソルデータを深層学習モデルに直接入力し、空間配置と波長情報の両方を活用した検出手法を検証しています。
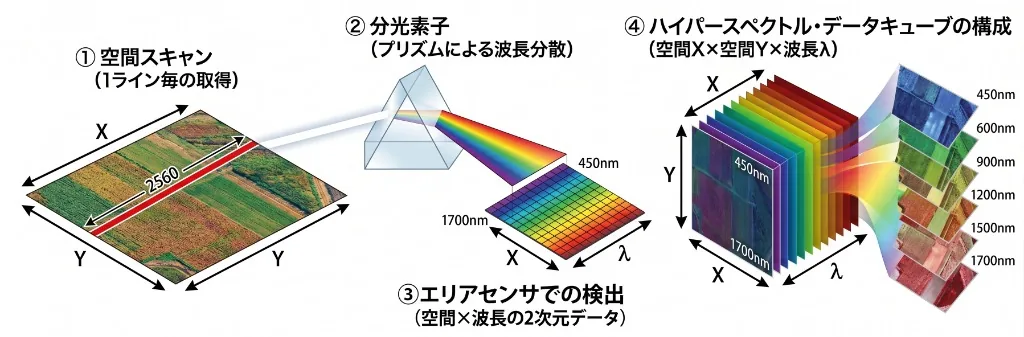
図: ハイパースペクトルカメラにおける①空間スキャン(ライン取得)、②分光素子による波長分散、③2次元エリアセンサによる空間×波長検出、④空間2軸+波長1軸からなる「3次元データキューブ(Data Cube)」の再構成プロセス。
2. X2Cube 分光デモザイク(モザイクセンサから 16ch テンソルへ)
本システムで使用する XIMEA スナップショットカメラは、各受光素子の上に 4×4(計 16 種類)のナノ光学バンドパスフィルタが周期的に配置されています。1 回の撮影で 16 波長の空間・波長情報がモザイク状に記録されます。
主催者標準アルゴリズム X2Cube は、この \(H \times W\) の単一チャンネル生画像から空間サンプリングと補間を行い、\(H \times W \times 16\) のハイパースペクトルデータキューブ(3次元テンソル)を再構成します。
図 1: XIMEA 4×4 ナノ分光フィルタアレイからの空間・波長デモザイク処理。全画素に 16 次元の分光反射率ベクトルが定義される。
3. 生物学的脳(神経細胞・シナプス)と人工ニューラルネットワークの比較
ディープラーニング(深層学習)の基礎となる人工ニューラルネットワーク(ANN)は、人間の大脳皮質に存在する神経細胞(ニューロン)とシナプス結合の情報伝達メカニズムを着想源として数理モデル化されたものです。
図 2: 生物学的ニューロン(樹状突起・軸索・シナプス結合)と人工ニューロン(加重和・活性化関数・重みパラメータ)の構造対応。
規模・結合数・情報処理方式の比較
人間の脳と人工ニューラルネットワーク(本モデル RF-DETR-Small や超巨大言語モデル)における素子数、結合数、エネルギー効率の比較は以下の通りです。
| 比較項目 | 人間の大脳皮質・脳全体 | OptiScan-HSI(RF-DETR-Small) | 超巨大基盤モデル(LLM / GPT-4級) |
|---|---|---|---|
| 基本素子(細胞 / 単位) | 神経細胞(ニューロン): 約 860 億個(8.6 × 10¹⁰) | 人工ニューロン・ノード: 数万 〜 数十万個 | 人工ニューロン: 数千万 〜 数億個 |
| 結合数(シナプス / 重み) | シナプス結合: 約 100 兆 〜 150 兆個(10¹⁴) | 学習パラメータ数: 約 2,200 万個(2.2 × 10⁷) | パラメータ数: 約 1 兆個(10¹²) |
| 信号伝達の形態 | 電気化学的スパイク(活動電位・全か無かの非同期パルス) | 連続値浮動小数点数(FP16 / FP32 テンソル) | 連続値浮動小数点数(FP8 / FP16 テンソル) |
| 学習・可塑性メカニズム | シナプス可塑性(ヘッブ則 / LTP・LTD、局所的更新) | 誤差逆伝播法(Backpropagation / AdamW 最適化) | 誤差逆伝播法(分散同期並列勾配降下法) |
| 消費電力・エネルギー効率 | 約 20 W(極めて高効率な生体代謝駆動) | 約 70 W 〜 250 W(GPU 1台の電力) | 数メガワット(MW)(データセンタ規模) |
| 視覚受容波長(チャネル数) | 網膜 3種錐体(S, M, L: 約 430nm, 530nm, 560nm) | 16 波長バンド分光テンソル(460 nm 〜 600 nm) | RGB 3 チャンネル画像パッチ |
図 3: 人間の脳(網膜 3 色錐体による色知覚)と OptiScan-HSI(16 波長テンソル × Transformer)の視覚処理経路の対比。
4. RF-DETR-Small テンソル推論設計
OptiScan-HSI では、物体検出の基盤モデルとして Apache-2.0 ライセンスの RF-DETR-Small を採用しています。通常の 3 チャンネル RGB 入力向けモデルに対し、パッチ埋め込み層(Patch Embedding)を 16 チャンネルに拡張することで、波長間 Self-Attention を直接機能させています。
図 4: OptiScan-HSI の RF-DETR テンソル推論アーキテクチャ。16ch パッチ埋め込みと Multi-Scale Transformer による真贋分離。
2段階の学習検証(Phase A → Phase B)
初期検証の迅速化とモデル性能の最大化を両立するため、以下の 2 段階ステップで学習と評価を実施しています。
Phase A: 疑似RGBベースライン
主催者推奨の 3 バンドデモザイクにより疑似 RGB 画像(num_channels=3)を生成。事前学習済み RF-DETR-Small を適用し、データローダー、VOC→COCO 変換、K-Fold 分割などのパイプライン健全性とベースライン精度を迅速に確認します。
Phase B: 16バンド直接テンソル入力
モデルのパッチ埋め込み層を num_channels=16 に拡張。Phase A で学習した 3ch の重みを 16 バンドへ展開初期化(Transfer Initialization)し、全帯域(460〜600 nm)の分光シグネチャを直接 Transformer に入力して材質判別精度を向上させます。
5. 波長間 Self-Attention(Spectral Attention)の数理とメカニズム
ハイパースペクトル物体検出において最も重要な課題は、「照明の強弱や影などの環境光ノイズに左右されず、対象物質そのものが持つ分光反射率プロファイルをいかに安定して抽出するか」 です。
単純な 2D CNN や画素ごとの輝度差分だけでは、被写体の傾きや影によって波長ごとの絶対値が変動し誤認識が生じます。そこで OptiScan-HSI では、Transformer の Self-Attention 機構を用いて「16 波長間の相対的な相関関係(共起パターン)」を直接モデリングしています。
※ Q_λ, K_λ ∈ ℝ¹⁶ˣᵈ : 各波長チャネルの射影ベクトル、Attention Map ∈ ℝ¹⁶ˣ¹⁶ : 波長間相互依存度
図 5: 波長間 Self-Attention の計算メカニズム。全波長チャネル間の Query-Key 内積から 16×16 相関行列を算出し、材質固有の分光結合パターンを抽出。
図 6: 幾何学的輪郭(空間 Attention)と分光シグネチャ(波長 Attention)の役割分担。外見トラップを分光特徴で解消する統合パイプライン。
6. 5組の材質ペアと分光反射率シグネチャ
データセットに含まれる主な材質ペア(全 18 クラス中 11 クラス)における、波長 460 nm 〜 600 nm の分光反射率特性の違いを図解します。
図 7: 16波長可視光(460–600 nm)における材質別分光シグネチャの例。材質ごとの反射率傾向の差異を分類に活用。
| 対象カテゴリ | 実物クラス | 模造品・異材質クラス | 分光スペクトルにおける主な特徴 |
|---|---|---|---|
| リンゴ | apple |
apple_plastic(樹脂製) |
果皮の色素・生体水分による波長依存の吸収 vs 樹脂成形品特有の反射特性 |
| バナナ | banana |
banana_plastic(樹脂製) |
天然色素(カロテノイド)の分光プロファイル vs プラスチック顔料反射 |
| オレンジ | orange |
orange_plastic(樹脂製) |
柑橘類表皮の散乱・分光特性 vs 人工樹脂の反射特性 |
| 自動車 | car(実車) |
car_toy(ミニカー・玩具) |
自動車用塗膜・金属ボディの反射 vs 玩具用塗料・プラスチック成形面の反射 |
| 卵 | egg(生卵・殻) |
egg_plastic, egg_wood(木製) |
卵殻の炭酸カルシウム分光特性 vs プラスチック vs 木材リグニン/セルロース特性 |
7. データセット監査と層化分割(Stratified Split)
本データセット(学習 3,000 枚 / テスト 1,000 枚)の読み込み時にデータ品質監査を実施し、以下の前処理および検証分割を行いました。
図 8: データセット監査と層化分割(Seed 42)の流れ。アノテーションの不正値を自動修正し、18 クラスの比率を保って検証セットを隔離。
| 分割セット | 画像枚数 | 割合 | 用途と設計方針 |
|---|---|---|---|
| Train(学習) | 2,400 枚 | 80.0 % | 18クラスのバランスを保った層化分割(Stratified Split / Seed 42) |
| Val(検証) | 298 枚 | 9.9 % | エポックごとの mAP 算出、Early Stopping、学習率スケジューリング |
| Holdout(テスト模擬) | 299 枚 | 10.0 % | モデル選定・ハイパーパラメータ最終決定用の評価セット |
8. コンペティション参加モデルと実運用向け並行開発
当社が技術検証を進めている Kaggle Hyperspectral Object Detection Challenge 2026 では、提出規定として「最終推論における複数モデルのアンサンブル(Ensemble / Weighted Boxes Fusion (WBF) / NMS 融合)の禁止」が定められています。
これに対応するため、OptiScan-HSI プロジェクトでは、①コンペティション参加用の単一モデル(Single-Model)最適化 と、②製造現場や食品ラインでの実運用を見据えたマルチモデル・アンサンブルおよびエッジ推論モデル の 2 つの開発トラックを並行して推進しています。
コンペティション検証モデル(Single-Model 規定準拠)
アンサンブルによる誤差相殺に頼れないため、「16 バンド入力テンソルの波長アテンション」「パッチ埋め込み層の初期化」「分光データ拡張(Spectral Augmentation)」の質を重点的に高め、単体での汎化性能と収束性の向上を図ります。
産業展開・実運用モデル(並行開発トラック)
実工場の異物検査や食品ラインでは、複数バックボーンの WBF 融合(アンサンブル)による誤検知(偽陽性)低減、Test-Time Augmentation (TTA)、および TensorRT/ONNX によるエッジリアルタイム推論モデルの構築を進めています。
競技規定準拠モデルにおいては、単一アーキテクチャのポテンシャルを最大限に引き出すため、以下の最適化を重点的に実施しています。
- スペクトル空間のデータ拡張(Spectral Augmentation): 各波長チャンネルに対する微小なゲイン変動やノイズ付加を検討し、特定の照明環境に過剰適合しない分光表現の獲得を目指します。
- D-Fine 回帰デコーダの境界座標最適化: 微細な輪郭の座標回帰精度を安定させるため、GIoU Loss と L1 Loss の重み配分を調整。
9. 箱ずれ(Localization Error)の診断と改善設計
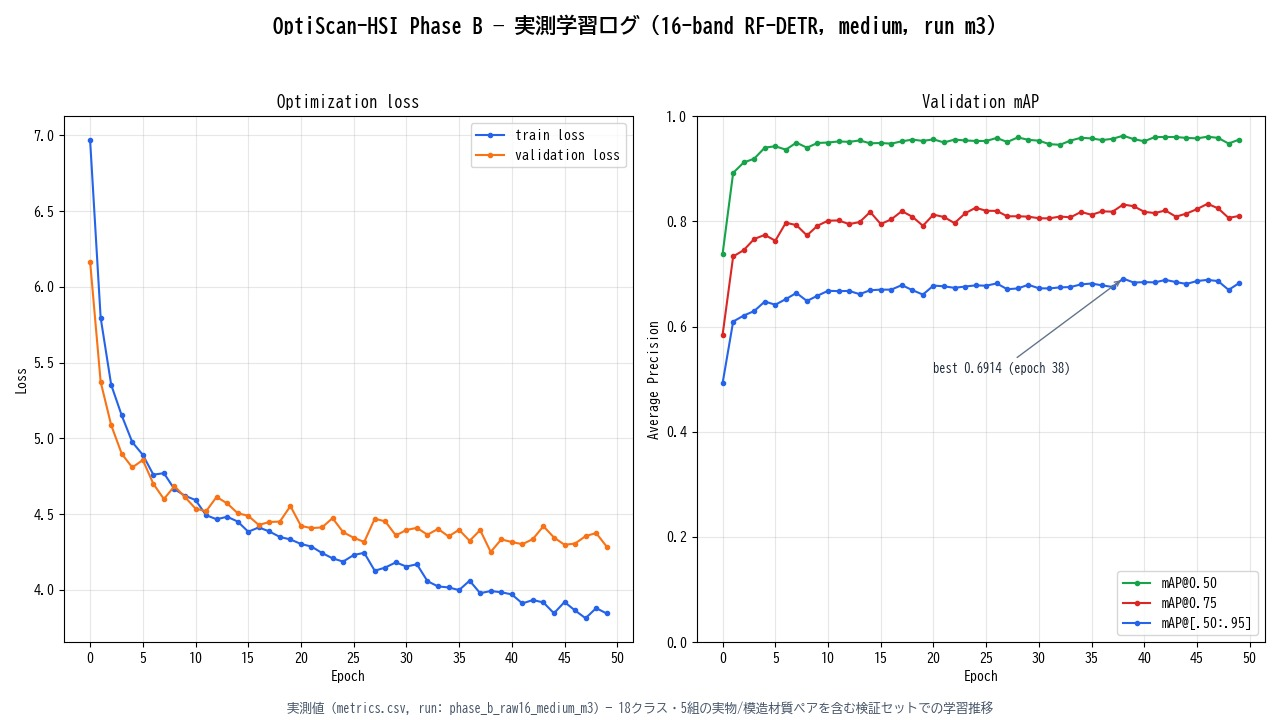
物体の種類を正しく識別できても、予測ボックスが正解境界から数ピクセルずれると、厳しい IoU 条件では不正解として扱われます。Phase B の検証では mAP@0.5 = 0.9640 に対し、IoU 0.50〜0.95を平均する mAP@[.5:.95] = 0.6978 でした。この 0.2662 の差から、主な残課題をクラス認識よりも境界座標の精密化と判断しました。
mAP@0.5
mAP@[.5:.95]
Localization gap
従来: 正方形リサイズによる境界ずれ
改善設計: アスペクト比を保持 実施済み
図 8: 箱ずれと改善方針の概念図。右図は設計目標であり、Small-v2 の実測結果ではありません。
| 観測した課題 | 原因仮説 | 実施した対策 | 検証状態 |
|---|---|---|---|
| mAP@0.5 は高いが高IoUで低下 | 横長画像を正方形へ変形した際の幾何歪み | 短辺384px、約384×768pxでアスペクト比を保持 | Small-v2 で実施 → 確認分割 C1 で val 0.7168 を記録 |
| 境界座標の微調整不足 | 完了済みモデルへ大きな学習率を継続 | Phase B最良重みから低学習率で20 epochs再調整 | Small-v2 で実施 → C1 ゲート未達(Δ−0.00083)で不採用 |
| 照明・センサ変動による特徴揺らぎ | 分光シグネチャへの過適合 | 微小ゲイン、16バンド傾斜、微弱ノイズのみを付与 | Small-v2 で実施・C1 で同一条件確認済み |
| 評価分割固有の改善に見える危険 | validationへの過適合 | 重複0件の299画像holdoutで独立評価 | 0.6886(validation比 −0.0092) |
16バンド化により validation mAP は Phase A の 0.674 から Phase B の 0.6978へ改善しました。その後、Small-v2・RF-DETR-Medium(M3)・単一チェックポイントTTA・確認分割 C1・全データ最終学習(F1)という系統的な検証を経て、Phase-1 暫定スコアは 0.64687(6位/20)に到達。最終フェーズ(Phase 2、test+ranking 2,000枚で採点)では M3+4パス TTA を primary として選択し、最終順位 43位・スコア 0.63647 でした(コンペ終了、2026年9月27日)。単一チェックポイント TTA のため複数モデルのアンサンブル禁止規定には抵触していません。
10. ハイパーパラメータ設計と学習設定
OptiScan-HSI では、単一モデル制約(アンサンブル禁止)下で安定した収束と過学習抑制を両立するため、オプティマイザ、学習率スケジューラ、損失関数の重みバランス、分光データ拡張の各ハイパーパラメータを体系的に設定しています。
| カテゴリ | パラメータ項目 | 設定値 | 選定理由と設計意図 |
|---|---|---|---|
| オプティマイザ & 学習率 |
最適化アルゴリズム | AdamW (β₁=0.9, β₂=0.999) | Transformer の重み減衰(Weight Decay: 1e-4)を安定制御 |
| バックボーン学習率 | Baseline 1.5×10⁻⁴ Small-v2 1.5×10⁻⁵ |
完了済みPhase BからSmall-v2へ移る際は10分の1へ下げ、空間特徴を保持 | |
| 16ch パッチ埋め込み & ヘッド学習率 | Baseline 1.0×10⁻⁴ Small-v2 3.0×10⁻⁵ |
16バンド入力層と検出ヘッドを、バックボーンより速く微調整 | |
| スケジューラ / Warmup | Baseline Step Small-v2 Cosine (Warmup 1ep, min factor 0.1) |
Baseline最良重みからの再調整では1 epochのwarmup後に学習率を滑らかに減衰 | |
| 学習環境 & バッチ設定 |
入力テンソル解像度 | Baseline 512×512×16 Small-v2 約384×768×16 |
Small-v2は短辺384pxで元の約2:1アスペクト比を保持し、境界の幾何歪みを抑制 |
| バッチサイズ & 勾配累積 | Baseline 4×Accum 4 Small-v2 2×Accum 8(実質16) |
T4のVRAM内で入力形状を保持しながら、実効バッチ16を維持 | |
| 総エポック数 / 早期終了 | Baseline 50ep Small-v2 20ep(Early Stopなし) |
validationで最良重みを保存し、holdoutは独立評価にのみ使用 | |
| マルチタスク 損失関数 |
分類損失(IA-BCE) | λ_cls = 1.0 | RF-DETRのIoU-aware分類目的を維持し、単一モデルで18クラスを学習 |
| BBox L1 回帰損失 | RF-DETR v1.8.1 既定設定 | バウンディングボックス中心座標・サイズの絶対誤差を補正 | |
| GIoU 損失 | RF-DETR v1.8.1 既定設定 | 重なり面積(IoU)と外接矩形の幾何学的形状整合性を最適化 | |
| 分光 & 空間 データ拡張 |
分光ゲインジッター(Spectral Gain) | Global gain U(0.95, 1.05) | 16バンドの相対関係を壊さず、照明強度の小変動へ対応 |
| 波長傾斜 + 分光ガウスノイズ | Tilt U(−0.03, 0.03) Noise σ=0.0002 |
波長方向の緩やかな感度差と微弱なセンサノイズを再現 | |
| 幾何空間拡張 | CPU幾何拡張 + Aspect-ratio preserve | 全16バンドへ同一の幾何変換を適用し、PIL/RGB変換を介さない | |
| 推論 & デコード設定 |
DETR クエリ数 / Top-k | 300 Queries | 画像内の密集配置物体の検出漏れを防止 |
| 確信度閾値 / 後処理 | Validation選択 0.001 追加NMS・box scaleなし |
0.001〜0.05のmAP差は約0.001。閾値だけの改善を過大評価しない |
完了済み Phase B では 512×512 の正方形入力で基準性能を確立しました。Small-v2 では、最良重みを初期値としてバックボーン学習率を 1.5×10⁻⁵、その他を 3.0×10⁻⁵へ下げ、元画像の約2:1アスペクト比を保持して境界座標を再調整します。分光拡張はRGB向けの色相変換や強いCutMixを避け、16バンドの物理的な連続性を保つ微小変動だけに限定しています。